• Cómo elegir conmutadores de centro de datos de próxima generación para cargas de trabajo de IA y redes de alto rendimiento
    October 26, 2026
    El conmutador que elijas influye en el rendimiento de las GPU y en la velocidad de finalización de las tareas. En un centro de datos de IA, los conmutadores deben gestionar el tráfico entre los nodos de GPU a alta velocidad de forma continua, con una latencia baja y constante. Un punto débil ralentiza las operaciones grupales y deja recursos computacionales costosos inactivos.¿Qué debería guiar tu elección cuando eliges? conmutadores de centro de datos de próxima generación ¿Buscas soluciones para IA y redes de alto rendimiento? Necesitas una comparación justa de las tecnologías y una lista de verificación práctica, no meras afirmaciones de los proveedores.Ailink le guiará a través del rendimiento, la idoneidad de la aplicación, el cumplimiento normativo y el coste. Al finalizar, contará con pruebas que podrá defender ante su equipo y una hoja de ruta clara para tomar una decisión bien fundamentada.Conclusiones claveAdapta el conmutador a tu carga de trabajo de IA. Las tareas de entrenamiento de gran tamaño requieren baja latencia y alto ancho de banda.Pruebe los conmutadores con tráfico de IA real. Solicite el rendimiento, la latencia de cola y el tiempo de finalización de la tarea.Ajusta cuidadosamente el control de congestión. Puede mejorar el rendimiento hasta en un 40%.Comprueba la eficiencia energética. Los racks de IA consumen mucha energía, así que elige conmutadores eficientes.Calcule el costo total. Incluya la óptica, las licencias, la energía y las habilidades del personal.Cómo la IA transforma las demandas de conmutaciónTráfico este-oeste y operaciones colectivasLas redes empresariales tradicionales suelen transportar tráfico norte-sur, es decir, solicitudes de usuario a servidor. Los clústeres de IA funcionan de manera diferente. Generan un enorme tráfico este-oeste que se mueve lateralmente entre las GPU, los servidores y el almacenamiento, y este flujo lateral constituye la parte principal del entrenamiento de la IA.El entrenamiento distribuido implica el intercambio constante de gradientes, tensores, parámetros del modelo y la sincronización de datos. Gracias al paralelismo de datos, tensores y pipelines, cada GPU puede comunicarse con muchas otras simultáneamente. Esto genera patrones que consumen una gran cantidad de ancho de banda, como All-Reduce, All-Gather, Broadcast y Reduce-Scatter.Aspecto¿Qué sucede en los clústeres de IA?Dirección del tráficoEl tráfico este-oeste es el flujo principal; el tráfico norte-sur es el segundo.forma del tráficoUnos pocos flujos enormes y duraderos en lugar de muchos pequeños.SensibilidadLos colectivos reaccionan fuertemente a la latencia, la pérdida de paquetes, la congestión, la fluctuación y la sobreasignación.Las operaciones colectivas son muy sensibles a la latencia. Incluso un pequeño retardo de sincronización deja inactivas las costosas GPU, por lo que una latencia baja y constante es más importante que el rendimiento máximo. Las redes utilizan diseños de tipo spine-leaf, diseños sin bloqueo o con baja sobreasignación y RDMA para minimizar los picos de latencia.Limitaciones de los diseños heredadosLas antiguas redes de tipo hoja-espina se diseñaron para el tráfico norte-sur con muchos flujos pequeños e intermitentes. En cambio, las cargas de trabajo de IA generan un pequeño conjunto de flujos enormes y de larga duración. Cada acelerador intercambia su estado con todos los demás, y cualquier retraso en una ruta paraliza toda la operación colectiva.La latencia de cola, no la latencia promedio, es la métrica clave aquí. Los flujos están sincronizados, por lo que el paquete más lento determina cuándo finaliza toda la operación. Los diseños tradicionales no optimizan esto. Las bibliotecas de entrenamiento de IA también asumen cero pérdida de paquetes. Un solo paquete perdido puede obligar a retransmitir grandes conjuntos de datos o a reiniciar completamente desde el punto de control.Las rutas múltiples estáticas de igual coste y la distribución aleatoria de paquetes ya no son suficientemente eficaces. Las soluciones temporales no alcanzan los niveles de rendimiento que exigen las cargas de trabajo de IA, dado que estas cambian más rápido que la capacidad de adaptación de las redes tradicionales. El mercado se orienta hacia una mayor eficiencia energética, una menor latencia en la red y una telemetría avanzada. Ethernet de alto rendimiento, basada en estándares abiertos, con interfaces de hasta 800 GbE y sistemas de refrigeración líquida, marca la dirección que están tomando los diseños. Ailink realiza un seguimiento de estas tendencias sin favorecer a ningún proveedor.InfiniBand frente a Ultra EthernetRendimiento, ajuste, cumplimiento, costeAmbas redes pueden transmitir tráfico de IA a alta velocidad. La diferencia radica en cómo lo hacen. InfiniBand utiliza una red dedicada sin pérdidas con computación en red. Ethernet con RoCE integra RDMA en una base de estándares abiertos y conocidos. La siguiente tabla muestra una comparación teórica de una plataforma InfiniBand representativa.EspecificaciónConmutador InfiniBand NVIDIA MQM9790-NS2R Quantum-2 NDRGeneraciónNDR 400GPuertos64 x 400G (32 conectores OSFP)Ancho de banda agregado51,2 Tbps, sin bloqueoLatencia de conmutaciónSubmicrosegundosComputación en redSHARP v4EnfriamientoLíquido (QM9790); aire en QM9700Potencia típica~800–1200 WCumplimientoEspecificación IBTA v1.5Precio indicado$30,000.00Opciones Ethernet como la Switch central de la serie 9700 de Dell Networking InfiniBand y otros conmutadores compatibles con RoCE compiten en apertura y facilidad de uso. Utilizan herramientas Ethernet estándar y se adaptan a entornos de múltiples proveedores. Los requisitos de cumplimiento también difieren. InfiniBand cumple con IBTA v1.5, mientras que Ethernet se ajusta a los estándares IEEE y RoCE que probablemente su equipo ya conoce.El costo no se limita al precio de lista. El switch NVIDIA tiene un precio superior, y su administrador de subredes y herramientas UFM añaden costos de licencia y personal especializado. Los switches Ethernet suelen ser más económicos por puerto y permiten reutilizar el conocimiento del personal existente. El consumo de energía también es importante. Un switch Quantum-2 refrigerado por aire, completamente equipado, consume entre 800 y 1200 vatios, según la óptica y la carga de tráfico. Compare esta cifra con el presupuesto de energía de su rack antes de tomar una decisión.Donde cada uno encaja mejorLos benchmarks revelan una historia compleja. En MLPerf Training para BERT-Large, Ethernet completó el entrenamiento en 10.886 segundos frente a los 10.951 segundos de InfiniBand, una ligera ventaja para Ethernet. En MLPerf Inference para LLAMA2-70B-99.9, InfiniBand fue un 1,66 % más rápido. En múltiples pruebas de IA generativa, ambos sistemas tuvieron un rendimiento casi idéntico, con una diferencia inferior al 0,03 %. La velocidad bruta rara vez determina la elección por sí sola.La forma de la carga de trabajo es un factor determinante. El entrenamiento síncrono de datos a gran escala con 8 o más GPU y decenas de miles de millones de parámetros se beneficia de la baja latencia y el alto ancho de banda de InfiniBand. FSDP, ZeRO-3 y el paralelismo tensorial también se benefician, ya que las operaciones colectivas frecuentes y de grano fino reaccionan bruscamente ante cualquier retraso. Los modelos de 70 mil millones o más con grandes tamaños de lote globales hacen que el ancho de banda de la interconexión sea crucial.Ethernet se adapta bien a muchos otros casos. El paralelismo de la canalización gestiona el tráfico de activación punto a punto más pequeño y tolera la latencia. El entrenamiento asíncrono no tiene barreras de sincronización. Las configuraciones pequeñas de 2 a 4 GPU dependen de NVLink dentro del nodo. El servicio de inferencia casi nunca necesita InfiniBand, ya que NVLink gestiona el tráfico dentro del nodo y Ethernet de alta velocidad cubre los enlaces entre nodos.InfiniBand es la opción preferida para cargas de trabajo HPC estrechamente acopladas que requieren una latencia inferior a 5 microsegundos y computación en red, donde la infraestructura está dedicada a un único usuario y tipo de carga de trabajo. Ethernet moderna con la arquitectura adecuada es una alternativa viable para entornos multiusuario, cargas de trabajo mixtas u organizaciones que buscan evitar la dependencia de un proveedor.Ninguna de las opciones es incorrecta. Adapta la infraestructura a tu carga de trabajo, las habilidades de tu equipo y tu presupuesto. Ailink te ayuda a evaluar ambas alternativas para tus switches de centro de datos de próxima generación sin imponerte ningún proveedor.Características importantes en los switches de próxima generaciónAncho de banda, latencia, control de congestiónLas velocidades de los puertos ahora alcanzan los 800 GbE, y los puertos de alta densidad de 100G, 200G y 400G satisfacen las necesidades actuales de ancho de banda de las GPU. La velocidad bruta es solo el punto de partida. Cuatro capacidades determinan si la estructura de la red puede seguir el ritmo de los aceleradores.CapacidadQué buscarPor qué es importanteAncho de banda y densidad de puertosPuertos de 100G, 200G, 400G y el nuevo puerto de 800G.Satisface las necesidades de ancho de banda de los colectivos de formación distribuidos.Estado latenteLatencia baja y constante entre puertos, sin fluctuaciones bajo carga.Evita que haya rezagados en colectivos síncronos.Almacenamiento en búferBúferes profundos y compartidos dinámicamenteAbsorbe microrráfagas y lluvias torrenciales sin goteos.Control de congestiónRoCEv2 con DCQCN, marcado ECN, PFC bajo 802.1QbbMantiene el transporte RoCE sin pérdidas y el rendimiento constante.El control de congestión merece un análisis detallado. DCQCN permite que las NIC reaccionen a las marcas ECN, y ECN marca los paquetes antes de que un conmutador los descarte. PFC pausa prioridades CoS específicas para proteger el tráfico RoCE sin pérdidas. OCI construyó una red RoCE escalada a miles de nodos y definió al menos tres perfiles de control de congestión para cargas de trabajo sensibles a la latencia, sensibles al rendimiento y mixtas. Aplicó PFC solo en una dirección en el borde entre los hosts y los conmutadores de la parte superior del rack, nunca a leaf o spine, lo que evita el bloqueo de la cabecera de la línea. ECN mantiene PFC rara vez necesario como salvaguarda de último recurso. Los clústeres más pequeños pueden ejecutar Zero Touch RoCE sin PFC ni ECN configurados en los conmutadores.Sin medidas de mitigación, la distribución desigual del tráfico y la congestión del enlace ascendente reducen el rendimiento del entrenamiento en más del 30 % en una implementación. El hash en el QP de destino a través de la UDF del conmutador, combinado con el escalado de QP, proporcionó una mejora de hasta el 40 % para AllReduce. La admisión controlada por el receptor, donde la biblioteca colectiva y el transporte intercambian paquetes listos para enviar, limita aún más el tráfico en tránsito.Escalabilidad, programabilidad, telemetríaConsidere la escalabilidad, la programabilidad y la telemetría como criterios de selección, no como extras. Pregunte cómo crece la red más allá de miles de nodos, si el conmutador ofrece telemetría a nivel de flujo y cuánta configuración debe gestionar su equipo. La continuidad operativa también es importante. Los conmutadores Dell basados ​​en OS10 mantienen una interfaz de línea de comandos (CLI) familiar para los equipos que la valoran, y el conmutador central Dell Networking Serie 9700 se adapta a entornos estandarizados con esta herramienta.Elija conmutadores para centros de datos de última generación que cumplan con estos criterios y, a continuación, pruébelos con su propio tráfico antes de tomar una decisión.Lo que revelan las pruebas en el mundo realDatos de referencia de AI FabricsAntes de firmar, solicite datos reales: rendimiento, latencia y tiempo de finalización de tareas de plataformas que gestionan tráfico real de IA. Las hojas de ventas rara vez incluyen estas cifras. Solicítelas a su proveedor y a Ailink.El registro publicado es bueno para ambas arquitecturas. Meta construyó clústeres de IA gemelos, uno en InfiniBand y otro en Arista Ethernet, para su implementación de Llama 3. Meta no reportó cuellos de botella de red en ninguna de las arquitecturas. Meta también compartió detalles de ingeniería para un clúster RoCE de 24 000 GPU. Allí, tanto RoCE como InfiniBand se optimizaron para ofrecer un rendimiento equivalente, y los modelos más grandes se entrenaron en la arquitectura RoCE. En las pruebas NCCL, RoCE Ethernet iguala a InfiniBand en ancho de banda de comunicación colectivo. Las pruebas de laboratorio al estilo MLPerf ahora muestran diferencias en el tiempo de ejecución de tareas de solo una fracción de un porcentaje.La latencia de cola sigue siendo la principal diferencia entre ambos. El control de flujo basado en créditos de InfiniBand elimina las pérdidas y proporciona un comportamiento muy estable en el peor de los casos. Una Ethernet para IA bien ajustada se acerca bastante, pero una configuración incorrecta de PFC puede provocar bloqueos en la cabecera de la cola o interbloqueos. La supercomputadora Colossus de xAI conectó 100 000 GPU NVIDIA Hopper a través de Ethernet Spectrum-X. Alcanzó un rendimiento de datos del 95 % con un control de congestión optimizado para el entrenamiento de IA en ráfagas. La Ethernet tradicional a la misma escala alcanza un máximo de aproximadamente el 60 % de rendimiento debido a miles de colisiones de flujo.Lecciones aprendidas de clústeres implementadosLos clústeres que ya están en uso enseñan lecciones sobre cómo elegir la herramienta adecuada para el trabajo. Un equipo que realiza una capacitación síncrona estrechamente acoplada en el Conmutador InfiniBand NVIDIA MQM9790-NS2R Quantum-2 NDR Se obtiene una latencia de cola constante y computación en red. Un equipo que estandariza Ethernet abierta con el conmutador central Dell Networking Serie 9700 obtiene operaciones familiares y flexibilidad entre diferentes proveedores.La elección del chip y del balanceo de carga también influye en el tiempo de finalización de las tareas. El Broadcom Jericho3-AI redujo el tiempo de finalización en más de un 10 % en comparación con los chips de la competencia. El Arista 7800R4 HyperPort, que combina 4 × 800 Gbps en 3,2 Tbps, acortó el tiempo de finalización en un 44 % en comparación con el balanceo de carga tradicional a través de puertos separados. Considere estos resultados como un motivo para realizar pruebas, no como una respuesta definitiva. Al elegir conmutadores de centro de datos de última generación, pruébelos en su propia red.Cómo elegir conmutadores de centro de datos de próxima generaciónElaboración de la lista de verificación de evaluaciónUna buena lista de verificación transforma una comparación vaga en una decisión justificable. Califica a cada candidato según seis áreas y asigna una ponderación a cada una según tus necesidades. La tabla a continuación muestra por qué las instalaciones de IA requieren soluciones diferentes a las de las residencias tradicionales.Área de criteriosCentro de datos tradicionalCentro de datos de IAAjuste de la carga de trabajoCargas de trabajo estables y predecibles.Cargas de trabajo dinámicas, intermitentes y con gran consumo de datos.Densidad de potencia del rack7–10 kW/rackDe 30 kW a más de 100 kW/rackEnfriamientoRefrigeración principalmente por aireRefrigeración líquida o híbridaRedes de contactosEthernet estándarInterconexiones de ancho de banda ultra alto y baja latenciaComience evaluando la idoneidad de la carga de trabajo. Pregunte si el conmutador mantiene un alto rendimiento y una baja latencia en múltiples nodos de GPU, y si gestiona bien el tráfico este-oeste. A continuación, pruebe el rendimiento con tráfico de IA real, no con picos de laboratorio. Finalmente, confirme la conformidad para cada región en la que implemente el sistema, ya que una presencia global garantiza la coherencia en el diseño del producto y acelera la implementación.La eficiencia energética merece una mención aparte. Los racks de IA de alta densidad ahora alcanzan entre 30 kW y más de 100 kW, y el NVIDIA GB200 NVL36 consume aproximadamente 66 kW, mientras que el NVL72 llega a unos 120 kW. Los modernos módulos conectables OSFP de 800G ofrecen un coste por gigabit un 40 % menor que las generaciones anteriores y un ahorro energético de aproximadamente el 50 % gracias al procesamiento digital de señales (DSP) y la modulación avanzados. Añada la telemetría como un elemento de evaluación. La información en tiempo real sobre el consumo energético y las cargas de la infraestructura evita el tiempo de inactividad, y los modelos de aprendizaje automático pueden detectar el deterioro de la refrigeración o la degradación de la señal de fibra antes de que se produzca un fallo. Por último, tenga en cuenta el coste total, incluidos los componentes ópticos, las licencias, la energía y las habilidades del personal.Validación con AilinkUna lista de verificación reduce las opciones. Las pruebas las confirman. Ailink ayuda a tu equipo a validar los conmutadores de centro de datos de última generación con tus propias cargas de trabajo de IA antes de comprometerte. Tú proporcionas tus perfiles de tráfico, patrones colectivos y presupuesto de energía. Ailink elabora el plan de pruebas en función de ellos.El proceso sigue un camino claro. Primero, se definen las cargas de trabajo relevantes, desde el entrenamiento síncrono hasta la inferencia. Segundo, Ailink realiza pruebas de rendimiento, latencia y tiempo de finalización de tareas en las arquitecturas candidatas. Tercero, se revisa la salida de telemetría y el consumo de energía bajo carga sostenida. Cuarto, se compara el costo total en toda la implementación.Este enfoque le permite elegir conmutadores de centro de datos de última generación basándose en datos concretos, en lugar de afirmaciones publicitarias. Al elegir conmutadores de centro de datos de última generación de esta manera, su equipo puede consultar las cifras antes de realizar la compra. Ailink comercializa todas las opciones aquí comparadas, por lo que la información proporcionada es imparcial y los resultados de las pruebas hablan por sí solos.Cinco factores deben guiar tu decisión: su adecuación a tu carga de trabajo, su velocidad real bajo tráfico de IA, el cumplimiento normativo, la eficiencia energética y el coste total. Si los tienes en cuenta todos, ninguna especificación técnica por sí sola te convencerá.Ejecuta la lista de verificación en cada candidato. Solicita datos de referencia de plataformas que manejan tráfico de IA real. Luego trabaja con Ailink Para probar las opciones con tus propias cargas de trabajo antes de tomar una decisión, esta información te permitirá elegir conmutadores de centro de datos de última generación con confianza, y tu equipo verá los datos que respaldan la decisión.Preguntas frecuentes¿Qué tejido debería elegir para una formación sincrónica a gran escala?InfiniBand es la mejor opción para el entrenamiento con alta conectividad. Su control de flujo basado en créditos mantiene la latencia de cola estable, y la computación en red acelera las operaciones colectivas. Ethernet con RoCE también funciona bien, una vez que se ajusta el control de congestión. Antes de decidir, elige la infraestructura que mejor se adapte a la forma de tu carga de trabajo, las habilidades de tu equipo y tu presupuesto.¿Hasta qué punto influye realmente el control de la congestión en los resultados?Esto los modifica considerablemente. En una implementación, el rendimiento del entrenamiento se redujo en más del 30 % debido al tráfico irregular y la congestión del enlace ascendente. El uso de hash en el QP de destino con escalado de QP permitió recuperar hasta un 40 % para AllReduce. Ajuste cuidadosamente ECN y PFC, y realice pruebas con su propio tráfico fluctuante.¿Necesitas puertos 800 GbE hoy en día?No siempre. Los puertos de 100G, 200G y 400G de alta densidad satisfacen la mayoría de las necesidades actuales de las GPU. Elija 800 GbE cuando su plan de desarrollo lo requiera. Los módulos OSFP de 800G modernos reducen el costo por gigabit en aproximadamente un 40 % y ahorran cerca de un 50 % de energía, por lo que la actualización resulta rentable a largo plazo.¿Cómo se comparan los proveedores de forma justa?Evalúe a cada candidato según su idoneidad para la carga de trabajo, rendimiento en condiciones reales, cumplimiento normativo, eficiencia energética, telemetría y coste total. Solicite datos sobre rendimiento, latencia y tiempo de finalización de tareas en entornos de IA en tiempo real. A continuación, permita que Ailink pruebe la lista de candidatos preseleccionados con sus propios perfiles de tráfico antes de tomar una decisión.¿Qué papel juega el poder en la decisión?Un dato importante. Los racks de IA ahora alcanzan entre 30 kW y más de 100 kW, y la NVIDIA GB200 NVL72 consume alrededor de 120 kW. Un switch Quantum-2 refrigerado por aire a plena carga consume aproximadamente entre 800 y 1200 vatios. Verifique cada cifra con respecto al consumo de energía y la refrigeración de su rack desde el principio.
  • Requisitos de hardware para servidores de IA: una lista de verificación práctica para GPU, memoria, almacenamiento y redes.
    October 20, 2026
    Requisitos de hardware para servidores de IA: una lista de verificación práctica para GPU, memoria, almacenamiento y redes. Construir un servidor de IA requiere más que seleccionar una GPU potente. Un servidor confiable Configuración del servidor de IA Es necesario equilibrar el rendimiento informático, la memoria del sistema, el rendimiento del almacenamiento, el ancho de banda de la red, el suministro de energía y la refrigeración para admitir cargas de trabajo específicas de manera eficiente. Ya sea que esté implementando servicios de inferencia de IA, ajustando modelos de aprendizaje automático, entrenando grandes modelos de lenguaje (LLM) o construyendo una infraestructura de datos de IA, comprender Requisitos de hardware del servidor de IA Es fundamental para evitar problemas de compatibilidad, cuellos de botella en el rendimiento y costes de adquisición innecesarios.Esta guía explica los componentes clave de un servidor de IA, cómo seleccionar el hardware para diferentes cargas de trabajo de IA y qué se debe comprobar antes de comprar componentes para el servidor. 1. Empiece por la carga de trabajo de IA antes de elegir el hardware.El derecho Hardware de servidor de IA Depende principalmente de lo que el sistema necesite lograr. Las diferentes cargas de trabajo imponen diferentes exigencias a la memoria de la GPU, la RAM del sistema, la capacidad de almacenamiento y el rendimiento de la red.Antes de seleccionar los componentes, defina la carga de trabajo, el rendimiento esperado, el volumen de datos y los requisitos de expansión futuros. Entrenamiento de modelos de IA frente a inferencia de IAEntrenamiento de modelos de IA Implica procesar grandes conjuntos de datos y actualizar repetidamente los parámetros del modelo. Generalmente requiere una capacidad de computación acelerada considerable, suficiente memoria GPU, un ancho de banda de memoria elevado y una entrega de datos eficiente. inferencia de IA Utiliza modelos entrenados para generar predicciones, clasificaciones o respuestas. Sus requisitos de hardware dependen del tamaño del modelo, la longitud de entrada y salida, los usuarios concurrentes, los objetivos de latencia y las expectativas de rendimiento. Por ejemplo, un servidor de inferencia que admita un modelo relativamente pequeño podría priorizar la capacidad de memoria de la GPU y la eficiencia de costos. Un entorno de entrenamiento distribuido podría requerir múltiples aceleradores y redes de alto ancho de banda para coordinar las tareas de computación entre servidores. Ajuste fino, RAG y análisis de datosOtras aplicaciones de IA tienen requisitos de infraestructura diferentes.Ajuste fino del modelo: Requiere suficiente memoria aceleradora, memoria del sistema y almacenamiento rápido para conjuntos de datos y puntos de control.Generación aumentada por recuperación (RAG): Puede requerir una combinación de recursos de GPU, capacidad de CPU, almacenamiento rápido y memoria para los servicios de procesamiento y recuperación de documentos.Análisis de datos mediante IA: A menudo se beneficia de un equilibrio entre los recursos de CPU, memoria, almacenamiento y red para la preparación y el procesamiento de datos.Formación distribuida a gran escala: Requiere una planificación minuciosa de las interconexiones del acelerador, la topología de la red, el rendimiento del almacenamiento y la sincronización de la carga de trabajo. Infraestructura de IA de servidor único frente a infraestructura de múltiples nodosUna configuración de servidor único puede simplificar la implementación y la gestión de cargas de trabajo pequeñas. Los proyectos de IA de mayor envergadura pueden requerir varios servidores conectados a través de una red de alto rendimiento. Al planificar un entorno multinodo, tenga en cuenta no solo las especificaciones de cada servidor, sino también cómo se mueven los datos entre los nodos. Una GPU potente no puede ofrecer todo su potencial si tiene que esperar con frecuencia a que lleguen los datos o se sincronicen en una red congestionada. 2. Componentes de hardware principales de un servidor de IAComprender la función de cada componente ayuda a los compradores a crear un equilibrio. Configuración del servidor de IA en lugar de seleccionar piezas individuales basándose únicamente en las especificaciones principales. GPU y CPU: Sentando las bases de la computaciónLas unidades de procesamiento gráfico (GPU) y otros aceleradores de IA realizan gran parte de los cálculos paralelos que requieren las cargas de trabajo de IA modernas. Su idoneidad depende del modelo, los requisitos de precisión, la capacidad de memoria, el software compatible y el rendimiento esperado. Al evaluar Componentes de servidor GPU, considerar:Capacidad de memoria del acelerador y ancho de banda de la memoriaRendimiento informático para la carga de trabajo previstaNúmero de aceleradoras compatibles con la plataformaConectividad PCIe y ranuras de expansión disponiblesConsumo de energía, refrigeración y dimensiones físicasCompatibilidad con software, controladores y marcos de trabajoLa CPU sigue siendo importante para la preparación de datos, la orquestación, las operaciones de almacenamiento y otras tareas que dan soporte a las cargas de trabajo del acelerador.Para sistemas multi-GPU, verifique que la placa base, la CPU, el chasis y la fuente de alimentación sean compatibles con la configuración prevista. La disponibilidad de ranuras físicas por sí sola no garantiza que todas las GPU funcionen con la conectividad o el rendimiento esperados. Memoria del servidor: capacidad, ancho de banda y fiabilidadLa memoria del sistema almacena datos operativos, resultados intermedios, procesos de aplicaciones e información necesaria para las CPU y otros componentes del sistema.Para entornos empresariales, Memoria para servidor DDR5 ECC RDIMM Es una opción importante a evaluar cuando la plataforma del servidor la admite. La memoria ECC puede detectar y corregir ciertos tipos de errores de memoria, mientras que los módulos DIMM registrados están diseñados para arquitecturas de memoria de servidor compatibles. Al seleccionar Memoria del servidor de IA, considerar:Capacidad total de RAM del sistemaCanales de memoria y velocidades de datos admitidasRequisitos de ECC y DIMM registradosCompatibilidad de CPU y placa baseCapacidades DIMM compatibles y reglas de poblaciónRequisitos de memoria para el preprocesamiento de datos y cargas de trabajo concurrentes No dé por sentado que una mayor frecuencia de memoria por sí sola garantiza un mejor rendimiento de la aplicación. El rendimiento real depende de la plataforma completa, la configuración de la memoria, la carga de trabajo y las condiciones de funcionamiento compatibles. Por ejemplo, un servidor de IA que procesa grandes conjuntos de datos puede necesitar una cantidad considerable de RAM del sistema, incluso cuando la memoria de la GPU es la principal limitación durante la ejecución del modelo. Antes de realizar el pedido Memoria DDR5 ECC RDIMMConsulte la lista de compatibilidad del fabricante del servidor y las configuraciones de memoria compatibles con la plataforma de la CPU. Unidades SSD NVMe: Almacenamiento rápido para cargas de trabajo de IA activasEl rendimiento del almacenamiento puede afectar directamente a la rapidez con la que un servidor de IA carga modelos, accede a conjuntos de datos, escribe puntos de control y procesa archivos intermedios.SSD NVMe Se utilizan habitualmente para cargas de trabajo de IA activas porque proporcionan acceso de baja latencia y alto rendimiento cuando se implementan en una plataforma compatible. Al elegir Unidades SSD empresariales para servidores de IA, evaluar:Capacidad y bahías de unidades disponiblesProtocolo NVMe e interfaz compatibleRendimiento de lectura/escritura secuencial y aleatoriaCalificaciones de resistencia y carga de trabajo de escritura previstaProtección contra pérdida de energía y otras funciones empresariales, cuando sea necesario.Gestión térmica y rendimiento sostenidoCompatibilidad con el software del servidor, la placa base y el almacenamiento.Una unidad SSD rápida puede mejorar la entrega de datos, pero los requisitos de almacenamiento varían. Una carga de trabajo que accede repetidamente a un modelo relativamente pequeño puede tener necesidades de almacenamiento diferentes a las de una canalización que procesa grandes conjuntos de datos de forma continua. También es importante distinguir las especificaciones de la interfaz del rendimiento real de la aplicación. Los resultados reales dependen de la profundidad de la cola, los patrones de carga de trabajo, la resistencia de la unidad, las condiciones térmicas y la configuración del sistema. Discos duros empresariales: almacenamiento de alta capacidad para datos de IADiscos duros empresariales Siguen siendo útiles para grandes conjuntos de datos, registros históricos, copias de seguridad y otras cargas de trabajo de almacenamiento donde la capacidad y el coste por terabyte son importantes. En comparación con las unidades SSD, los discos duros (HDD) generalmente ofrecen un rendimiento de acceso aleatorio inferior. Sin embargo, pueden ser adecuados para niveles de almacenamiento orientados a la capacidad cuando la aplicación no requiere la latencia de una unidad SSD. Al seleccionar discos duros empresariales, considerar:Capacidad de almacenamiento útil requeridaCapacidad de carga de trabajo del variador y condiciones de funcionamiento previstasCompatibilidad de interfaz y servidorRequisitos de redundancia y protección de datosPolíticas de copia de seguridad y recuperaciónPotencia, refrigeración y densidad de almacenamientoUna arquitectura de almacenamiento por niveles puede combinar unidades SSD NVMe para los datos de acceso frecuente con discos duros de alta capacidad para la información de acceso menos frecuente. El equilibrio adecuado depende de los patrones de acceso, los requisitos de disponibilidad y el presupuesto. Controladores HBA y RAID: Gestión de la conectividad de almacenamientoUn adaptador de bus de host (HBA) y un controlador RAID cumplen funciones diferentes, por lo que la elección correcta depende de la arquitectura de almacenamiento.Un HBA Normalmente proporciona conectividad entre el sistema anfitrión y los dispositivos de almacenamiento compatibles. controlador RAID Puede proporcionar funcionalidad RAID asistida por hardware cuando el controlador y la configuración lo permiten. Antes de seleccionar un controlador, verifique:Interfaces y protocolos de unidades compatiblesNúmero de unidades compatibles y puertos disponiblesCompatibilidad con el plano posterior del servidorNiveles RAID y funciones de protección de datos requeridosSoporte para sistemas operativos y controladoresIntegración con la arquitectura de almacenamiento prevista.En el caso del almacenamiento definido por software, el acceso directo a la unidad puede ser preferible en algunos diseños. Otras implementaciones pueden requerir funcionalidad RAID basada en controlador.RAID no debe considerarse un sustituto de las copias de seguridad. La protección de datos requiere una estrategia más amplia que tenga en cuenta la redundancia, los procedimientos de recuperación y las consecuencias de los fallos de hardware o software. Tarjetas de red, conmutadores y transceptores ópticos: Conectando la infraestructura de IAEl rendimiento de la red cobra cada vez más importancia cuando las cargas de trabajo de IA transfieren grandes conjuntos de datos entre sistemas de almacenamiento, servidores y nodos de computación.El apropiado Redes de centros de datos de IA La configuración depende del volumen de tráfico, el número de nodos, la topología, la compatibilidad con protocolos, los requisitos de latencia y la escalabilidad futura. Los componentes clave incluyen:Tarjetas de interfaz de red (NIC): Conectar los servidores a la red.Conmutadores Ethernet: Proporcionar conectividad entre servidores, sistemas de almacenamiento y otros dispositivos de red.Transceptores ópticos: Convierte señales eléctricas y ópticas para enlaces de red compatibles.Cables de fibra óptica: Transmite señales ópticas entre interfaces compatibles.Para implementaciones de mayor envergadura, se pueden considerar velocidades de 100 GbE, 200 GbE, 400 GbE u 800 GbE, según las exigencias de la carga de trabajo y el diseño de la infraestructura. Estas velocidades no son requisitos universales para todos los servidores de IA. Al elegir transceptores ópticos de alta velocidadVerifique las especificaciones del conmutador y del puerto NIC, la velocidad de transmisión admitida, el alcance, el tipo de fibra, el conector, la longitud de onda y los requisitos de interoperabilidad. Una mayor velocidad de enlace no mejora automáticamente todas las aplicaciones. La red debe diseñarse en función de los patrones de tráfico reales, y el servidor, el conmutador, el transceptor y el cableado deben funcionar conjuntamente como un sistema compatible. Suministro de energía y refrigeración: Comprobando un rendimiento sostenidoLos aceleradores, las CPU, la memoria y los dispositivos de almacenamiento de alto rendimiento pueden generar importantes demandas de energía y calor.Al planificar Alimentación y refrigeración de servidores de IA, evaluar:Requisitos de potencia totales del sistemaCapacidad y redundancia del suministro eléctricoDistribución de energía y capacidad del circuitoRequisitos de flujo de aire del chasis y refrigeración de componentesDensidad de racks y capacidades de refrigeración de las instalacionesLímites de temperatura de funcionamientoComportamiento de carga de trabajo sostenida No dimensione una fuente de alimentación simplemente sumando las potencias nominales de los componentes sin tener en cuenta los requisitos del sistema y las recomendaciones del fabricante.Asimismo, una configuración que se ajuste físicamente a un chasis de servidor puede no ser térmicamente adecuada para un funcionamiento continuo. Es necesario validar la alimentación, el flujo de aire y la refrigeración para la configuración completa. 3. Configuración del servidor de IA según la carga de trabajoNo existe una especificación de hardware única que se adapte a todos los proyectos de IA. La siguiente tabla resume las prioridades típicas para diferentes escenarios de implementación.carga de trabajo de IAPrioridades principales del hardwareConsideraciones importantesinferencia de IAGPU o acelerador, memoria de la GPU, RAM del sistema, modelo de almacenamientoTamaño del modelo, concurrencia, latencia, rendimientoAjuste fino del modeloMemoria de GPU, capacidad de procesamiento, RAM del sistema, SSD NVMeTamaño del conjunto de datos, puntos de control, método de entrenamientoEntrenamiento distribuido de IAMúltiples aceleradores, redes de alto ancho de banda, almacenamiento rápidoTopología de interconexión, sincronización, escalabilidadAplicaciones RAGCPU, GPU cuando sea necesario, RAM, almacenamiento SSD, redVolumen de documentos, arquitectura de recuperación, latencia de respuestaProcesamiento de datos mediante IACPU, memoria del sistema, rendimiento de almacenamientoTransformación de datos, tamaño del lote, procesamiento paraleloConjuntos de datos y archivos de IAUnidades SSD y HDD empresariales, controladores de almacenamiento cuando correspondaCapacidad, frecuencia de acceso, redundancia, retenciónEstas son directrices de planificación, no listas de materiales fijas. Los requisitos reales varían según la arquitectura del modelo, el marco de trabajo, el conjunto de software, el volumen de datos, el objetivo de rendimiento y el entorno de implementación. Por ejemplo, un servicio de inferencia de IA con estrictos requisitos de latencia puede priorizar la memoria del acelerador y el acceso a datos de baja latencia. Un clúster de entrenamiento distribuido puede dar mayor importancia a las interconexiones del acelerador y al rendimiento de la red. Un buen punto de partida es documentar la carga de trabajo prevista y los objetivos de rendimiento antes de comparar los distintos productos. 4. Cómo equilibrar la GPU, la memoria, el almacenamiento y la red.Seleccionar los componentes adecuados es solo una parte del proceso. Un sistema bien diseñado Configuración del hardware del servidor de IA También debe evitarse la creación de cuellos de botella entre esos componentes. Identificar los cuellos de botella en computación y memoria.Comience por evaluar si el modelo y la carga de trabajo previstos caben dentro de la memoria aceleradora disponible y si la memoria RAM del sistema es suficiente para el preprocesamiento y los servicios de soporte.Si el modelo o la carga de trabajo superan los recursos disponibles, la solución puede implicar cambiar la configuración del hardware, optimizar el modelo, ajustar la carga de trabajo o distribuir el procesamiento entre varios dispositivos.La simple compra de una GPU más potente no resuelve todas las limitaciones de memoria o gestión de datos. Adapta el rendimiento del almacenamiento a los patrones de acceso a los datos.Determinar si la carga de trabajo requiere principalmente un alto rendimiento secuencial, lecturas aleatorias frecuentes, escrituras continuas o almacenamiento de gran capacidad.Para conjuntos de datos activos y archivos de modelos a los que se accede con frecuencia, Almacenamiento SSD NVMe puede ser apropiado. Para archivos grandes y conjuntos de datos a los que se accede con menos frecuencia, Almacenamiento HDD empresarial puede proporcionar un nivel de capacidad más económico.Mida los requisitos de la aplicación en lugar de asumir que todos los servidores de IA necesitan la misma configuración de almacenamiento. Determinar cuándo es necesaria la conexión de alta velocidad en red.Los requisitos de red dependen de la cantidad de datos que se transfieren entre servidores y de la frecuencia con la que las cargas de trabajo distribuidas intercambian información.En el entrenamiento con múltiples nodos, el rendimiento y la latencia de la red pueden afectar la eficiencia general. Para un servidor de inferencia independiente, una configuración de red más sencilla puede ser suficiente.Al evaluar Redes de 400 GbE y 800 GbEHay que tener en cuenta el tráfico previsto, la capacidad del conmutador, la compatibilidad con los dispositivos finales, la compatibilidad de los transceptores y el coste de actualizar la infraestructura en general.El objetivo es eliminar los cuellos de botella reales sin adquirir capacidad de red que la carga de trabajo no pueda utilizar eficazmente. Planificar la escalabilidad y el costo total de propiedad.Una solución rentable Configuración del servidor de IA Equilibra el costo de compra inicial con los gastos operativos y la expansión futura.Considere el costo total de propiedad (CTP), que incluye:Adquisición y reemplazo de hardwareElectricidad y refrigeraciónMantenimiento y garantíaCrecimiento del almacenamiento y protección de datosActualizaciones de redRequisitos de software y operativosCostos de implementación y migración futuraUn componente de bajo costo puede ser una mala elección si genera problemas de compatibilidad o requiere un rediseño costoso posteriormente. Por el contrario, las especificaciones premium pueden no estar justificadas cuando la carga de trabajo no se beneficia de ellas. 5. Lista de verificación de compatibilidad de hardware del servidor de IAAntes de comprar Componentes del servidor de IAVerifique la compatibilidad en todo el sistema. La siguiente lista de verificación puede ayudar a los equipos de compras e ingeniería a reducir los riesgos de configuración evitables. Compatibilidad de GPU y plataformaConfirme la compatibilidad de la GPU con el modelo de servidor y la placa base.Verifique las dimensiones físicas, el espaciado entre ranuras y los recursos PCIe disponibles.Verifique los conectores de alimentación, los límites de potencia y los requisitos de refrigeración.Confirme la compatibilidad con el número previsto de aceleradores.Validar los requisitos de firmware, controladores y software pertinentes. Compatibilidad de memoria del servidorConfirme si la plataforma requiere memoria ECC RDIMM, otro tipo de memoria compatible o una configuración DIMM específica.Compruebe la capacidad de memoria y las velocidades de transferencia de datos que admite la CPU.Siga las instrucciones del fabricante sobre la cantidad de memoria necesaria.Verifique los números de pieza de los módulos con la lista de compatibilidad.Confirme que se admiten las capacidades de mezcla o las especificaciones del módulo, si corresponde. Compatibilidad con el almacenamiento y el controladorConfirme la compatibilidad con la interfaz, el protocolo, el factor de forma y la capacidad de la unidad.Compruebe el panel posterior del servidor y las bahías de unidades disponibles.Verifique la compatibilidad del controlador HBA o RAID, según corresponda.Revise los requisitos del sistema operativo, el firmware y los controladores.Defina los requisitos de redundancia, copia de seguridad y recuperación. Compatibilidad de redes y ópticaConfirme las velocidades compatibles de los puertos de la tarjeta de red y del conmutador.Verifique el factor de forma del transceptor y las especificaciones de la interfaz.Verifique el tipo de fibra, el conector, la longitud de onda y la distancia de transmisión.Confirme los requisitos de compatibilidad para el conmutador y la tarjeta de red previstos.Evaluar la topología y la capacidad de la red para futuras expansiones. Alimentación, refrigeración e implementaciónValidar la demanda total de energía del sistema y la capacidad de suministro de energía.Compruebe el flujo de aire del chasis y los límites térmicos.Confirme el espacio disponible en los racks, la distribución de energía y la refrigeración de las instalaciones.Revise la garantía, la posibilidad de mantenimiento y los procedimientos de reemplazo.Pruebe la configuración completa antes de la implementación a gran escala.Las especificaciones individuales de un componente no garantizan la compatibilidad con todo el sistema. En caso de duda, consulte la documentación del fabricante del servidor y obtenga la confirmación técnica antes de realizar el pedido. 6. Cómo elaborar un plan práctico para la adquisición de servidores de IA.Un proceso de adquisición estructurado ayuda a garantizar que el hardware seleccionado cumpla con los requisitos operativos reales.Paso 1: Definir los requisitos de rendimiento y capacidad.Documentar la carga de trabajo de IA, el tamaño del modelo, el volumen del conjunto de datos, el rendimiento esperado, los objetivos de latencia, la concurrencia y el crecimiento previsto.Estos requisitos constituyen la base para evaluar las necesidades de CPU, GPU, memoria, almacenamiento y redes. Paso 2: Confirme los números de pieza exactos.Utilice los números de pieza exactos del fabricante al comparar. módulos de memoria del servidorSSD, HDD, controladores, NIC, conmutadores y transceptores ópticos.Los nombres de los productos y las especificaciones principales por sí solos pueden no revelar diferencias importantes en la interfaz, el firmware, el formato o la compatibilidad. Paso 3: Validar la configuración completaVerifique la lista completa de materiales comparándola con la plataforma del servidor, el entorno operativo y la implementación prevista.Para proyectos de mayor envergadura, valide una configuración de muestra antes de realizar compras por volumen. Esto puede ayudar a identificar problemas de interoperabilidad, rendimiento, temperatura o implementación antes de que afecten al proyecto en general. Paso 4: Evaluar los requisitos de suministro, garantía y ciclo de vida.Para la adquisición de hardware B2B, tenga en cuenta la disponibilidad del producto, los plazos de entrega, los términos de la garantía, las opciones de reemplazo y el estado del ciclo de vida.En el caso de despliegues en múltiples ubicaciones o por fases, la coherencia en los números de pieza y la continuidad del suministro pueden ser especialmente importantes. Paso 5: Comparar el costo total y la expansión futuraCompare las configuraciones en función de su capacidad para cumplir con los requisitos de rendimiento, no simplemente de sus precios iniciales de componentes.Una evaluación útil debe tener en cuenta los costos operativos, las rutas de actualización, los requisitos de soporte y el gasto potencial de reemplazar componentes incompatibles. 7. Errores comunes al planificar el hardware de un servidor de IAVarios errores recurrentes pueden socavar un diseño de infraestructura que, de otro modo, sería prometedor.Elegir las GPU antes de definir la carga de trabajo: La selección del acelerador debe tener en cuenta los requisitos del modelo, los objetivos de rendimiento y las limitaciones de implementación.Subestimar la memoria del sistema: La memoria de la GPU y la RAM del sistema cumplen funciones diferentes. Se necesita capacidad suficiente para el entorno completo de software y procesamiento de datos.Ignorar los cuellos de botella de almacenamiento: La lentitud en la entrega de datos o una arquitectura de almacenamiento inadecuada pueden reducir la eficiencia de las aplicaciones incluso cuando se dispone de recursos informáticos.Pasar por alto la compatibilidad de la red: Las tarjetas de red, los conmutadores, los transceptores ópticos y los cables deben ser compatibles con las interfaces, las velocidades y las condiciones de transmisión previstas.Mezclar componentes incompatibles: Los módulos de memoria, las unidades de disco y los productos de red de aspecto similar pueden tener diferentes requisitos de compatibilidad.Descuidar la alimentación eléctrica y la refrigeración: Las cargas de trabajo sostenidas pueden revelar limitaciones térmicas y de potencia que no son evidentes a partir de una simple lista de componentes.Considerar la redundancia como una estrategia de respaldo completa: RAID y otros mecanismos de redundancia no eliminan la necesidad de contar con procedimientos adecuados de copia de seguridad y recuperación.Comprar sin validar la configuración: La compatibilidad del sistema completo y la validación de la carga de trabajo son más fiables que las suposiciones basadas en las especificaciones de cada producto.Para evitar estos errores, es necesaria la coordinación entre los departamentos de ingeniería, compras, operaciones informáticas y proveedores de hardware. 8. Preguntas frecuentes sobre el hardware de los servidores de IA¿Qué hardware se necesita para construir un servidor de IA?Un típico servidor de IA Incluye una CPU, memoria del sistema, una o más GPU u otros aceleradores de IA cuando sea necesario, dispositivos de almacenamiento, interfaces de red, una placa base y un chasis compatibles, fuentes de alimentación y refrigeración. La configuración exacta depende del modelo, la carga de trabajo, los objetivos de rendimiento y la escala de implementación. ¿Cuánta RAM necesita un servidor de IA?El requerido Capacidad de RAM del servidor de IA Depende del sistema operativo, el software de modelado, el preprocesamiento de datos, las aplicaciones concurrentes y el tamaño de la carga de trabajo. La memoria de la GPU y la RAM del sistema son recursos independientes, por lo que deben evaluarse ambos. Verifique los límites de la plataforma y los requisitos de la aplicación antes de decidir la capacidad. ¿Es necesario un SSD NVMe para los servidores de IA?SSD NVMe Son útiles cuando las cargas de trabajo se benefician de un almacenamiento de baja latencia y un alto rendimiento, como la carga de modelos, el acceso a conjuntos de datos activos y la escritura de puntos de control. Sin embargo, no todos los servidores de IA requieren almacenamiento NVMe para cada nivel de datos. La selección del almacenamiento debe reflejar los patrones de acceso, las necesidades de capacidad y el presupuesto. ¿Los servidores de IA necesitan una red de 400G o de 800G?No. Redes de 400 GbE y 800 GbE Puede que sea apropiado para algunos clústeres de IA de alto ancho de banda, pero no es un requisito universal. La velocidad de la red debe seleccionarse en función de los patrones de tráfico, el número de nodos, los requisitos de la aplicación, la compatibilidad de los dispositivos finales y la arquitectura general de la red. ¿Cómo puedo comprobar la compatibilidad del hardware del servidor de IA?Comience con la documentación del fabricante del servidor y las listas de componentes compatibles. Confirme los números de pieza exactos, las especificaciones de memoria, las interfaces de las unidades, los requisitos de PCIe, la compatibilidad de la tarjeta de red y el transceptor, los límites de potencia y las restricciones de refrigeración. Valide la configuración completa antes de realizar compras al por mayor. ¿Debo elegir unidades SSD o HDD de nivel empresarial para el almacenamiento de IA?Elegir SSD empresariales cuando la baja latencia, las altas IOPS o el acceso rápido a los datos son importantes. Considere discos duros empresariales Para conjuntos de datos de gran capacidad, archivos y otras cargas de trabajo que toleran una mayor latencia de acceso. Muchos entornos se benefician de un diseño por niveles que combina ambos tipos de almacenamiento. ¿Qué debo tener en cuenta al comprar componentes de servidor de IA al por mayor?Evalúe los números de pieza exactos, la compatibilidad, la cantidad, la disponibilidad, los plazos de entrega, los términos de la garantía, el estado del ciclo de vida y la coherencia en todo el pedido. Para proyectos complejos, solicite una lista de materiales revisada y valide una configuración de muestra antes de proceder con la compra en volumen. Conclusión: Construir un servidor de IA en torno a la carga de trabajo.Exitoso Planificación del hardware del servidor de IA Todo comienza con la carga de trabajo, no con las especificaciones de un producto individual. Los recursos de la GPU y la CPU, la memoria del servidor, el almacenamiento, la red, el suministro de energía y la refrigeración deben funcionar conjuntamente para cumplir con los requisitos de rendimiento, fiabilidad y presupuesto del proyecto.Una estructurada Lista de verificación de hardware para servidores de IA Ayuda a los equipos a identificar riesgos de compatibilidad, evitar gastos innecesarios y planificar el crecimiento futuro. Al validar la configuración completa antes de la compra, las empresas pueden tomar decisiones más informadas sobre su infraestructura de IA.Para las organizaciones que buscan componentes de computación y redes empresariales, AILINK100 puede ser un buen punto de partida para explorar las categorías de hardware y las opciones de productos relevantes. Prepare el modelo de su servidor, la carga de trabajo prevista, las especificaciones requeridas, las cantidades estimadas y los requisitos de entrega antes de solicitar un presupuesto. ¿Necesita ayuda para conseguir hardware para servidores? Póngase en contacto con el equipo de AILINK100 para analizar sus requisitos de componentes e identificar los productos adecuados para una revisión de compatibilidad más exhaustiva y la planificación de la adquisición.
  • ¿Qué hace que la memoria DDR5-5600 ECC RDIMM sea ideal para servidores empresariales?
    ¿Qué hace que la memoria DDR5-5600 ECC RDIMM sea ideal para servidores empresariales?
    September 28, 2026
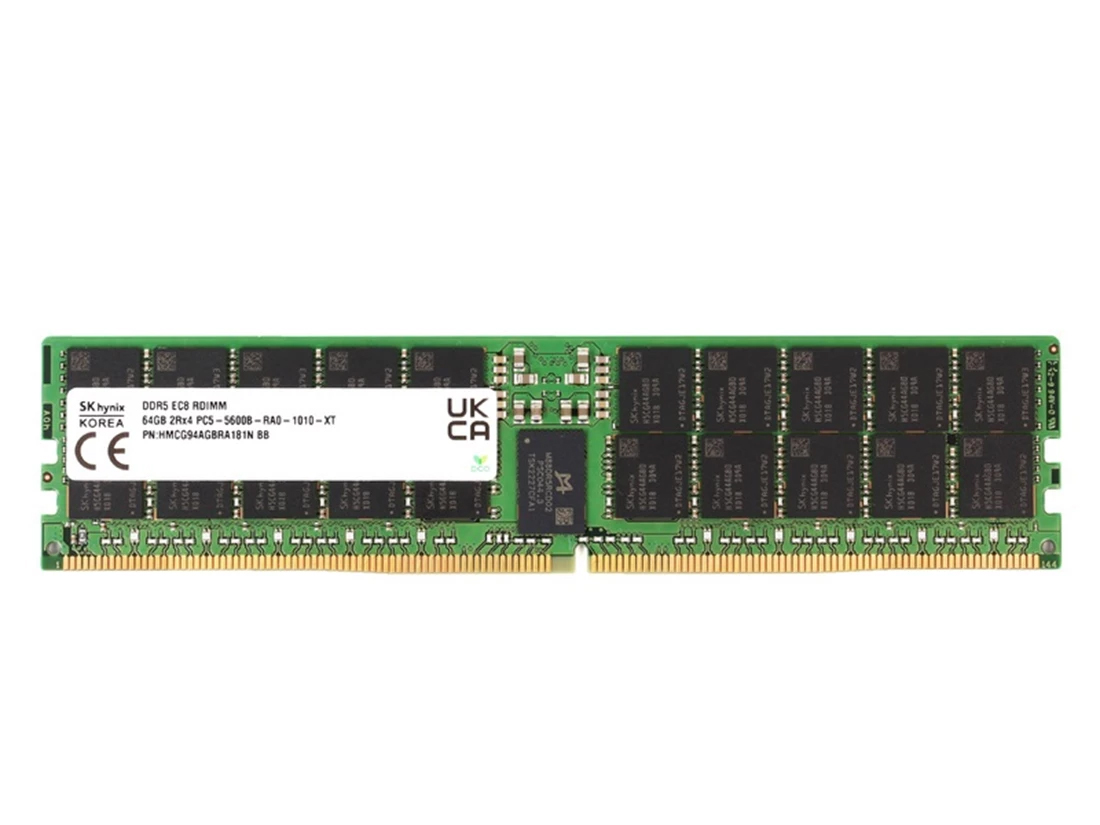
    Los servidores empresariales requieren memoria que equilibre velocidad, fiabilidad y escalabilidad. El módulo DDR5-5600 ECC RDIMM ofrece esta combinación. Obtendrá un rendimiento de alta velocidad de 5600 MHz (PC5-44800) para cargas de trabajo exigentes. La corrección de errores integrada corrige activamente los errores, protegiendo los datos críticos. El diseño registrado mantiene la integridad de la señal en múltiples módulos. Este módulo DDR5 ECC registrado RDIMM destaca en virtualización, bases de datos y computación de alto rendimiento (HPC). Como memoria de servidor de grado empresarial, elimina los cuellos de botella. La arquitectura DDR5 ECC registrado RDIMM admite grandes cantidades de memoria. Este módulo DDR5-5600MHz ECC registrado RDIMM es una memoria DDR5 ECC fiable para servidores empresariales. Memoria SK hynix DDR5-5600 Representa una solución completa. Obtendrá fiabilidad, rendimiento y escalabilidad en un solo módulo DDR5 RDIMM. Esta memoria para servidores empresariales garantiza un funcionamiento fluido de la infraestructura.Conclusiones claveLa corrección de errores ECC soluciona automáticamente los errores de memoria de un solo bit. Esto evita fallos del sistema y mantiene sus datos seguros.El diseño registrado reduce la carga en el controlador de memoria. Su servidor admite más módulos de memoria con señales estables.La memoria DDR5-5600 ofrece una velocidad de 5600 MHz con un consumo de tan solo 1,1 V. Obtendrás alto rendimiento y ahorro de energía.Esta memoria funciona con servidores Intel Xeon y AMD EPYC. Consulte siempre la lista de compatibilidad (QVL) de su servidor para comprobar la compatibilidad total.Los sensores térmicos integrados gestionan el calor y ajustan la frecuencia de actualización. Su servidor se mantiene estable incluso durante cargas de trabajo intensas.Función de la memoria DDR5-5600 ECC RDIMM en la fiabilidad de los servidoresCapacidades de corrección de errores ECCLa memoria DDR5-5600 ECC RDIMM ofrece corrección activa de errores para servidores empresariales. El código ECC (Código de Corrección de Errores) de este módulo corrige automáticamente los errores de memoria de un solo bit. Esta corrección evita fallos inesperados del sistema y la corrupción de datos en aplicaciones críticas. Esta protección es fundamental para cargas de trabajo como transacciones de bases de datos o procesamiento financiero. Un solo bit corrupto puede provocar costosos tiempos de inactividad. La memoria ECC elimina este riesgo al corregir los errores antes de que afecten a las operaciones.Los módulos DIMM ECC estándar implementan SECDED (corrección de errores simples, detección de errores dobles), que corrige cualquier error de un solo bit y detecta, pero no puede corregir, los errores de dos bits.Para entornos empresariales, la compatibilidad total con ECC proporciona una protección robusta. El módulo detecta y corrige la mayoría de los errores de memoria de forma silenciosa. Esta función mantiene la integridad de los datos sin intervención manual. Puede confiar en que su memoria DDR5 ECC gestionará los errores que, de otro modo, dañarían los datos o interrumpirían los servicios. La memoria SK hynix DDR5-5600 incorpora esta avanzada tecnología ECC. Como módulo RDIMM registrado DDR5 ECC, ofrece una protección superior contra errores. Obtendrá una fiabilidad comprobada para sus aplicaciones más exigentes.Diseño registrado para la integridad de la señalAdemás de la corrección de errores, el diseño registrado de este módulo DDR5 ECC Registered RDIMM mejora la integridad de la señal. Al instalar varios módulos de memoria en un servidor, la carga eléctrica aumenta. La arquitectura RDIMM reduce dicha carga en el controlador de memoria. Este diseño garantiza un funcionamiento estable incluso en configuraciones de alta capacidad.El controlador de memoria de su servidor envía señales de comando y dirección hacia los módulos de memoria.En un módulo DDR5 RDIMM, un registro integrado en el módulo (controlador de reloj registrado, RCD) recibe primero estas señales. Las señales no van directamente a todos los chips DRAM.El registro almacena en búfer las señales de comando y dirección, y luego las retransmite a los dispositivos DRAM.Debido a que el controlador de memoria solo controla la entrada de registro en lugar de toda la carga de la DRAM, la carga eléctrica directa sobre el controlador se reduce significativamente.Esta carga reducida mejora la integridad de la señal y permite que su sistema admita más módulos de memoria por canal y una mayor capacidad total. El RCD también mejora la integridad de la señal a altas frecuencias. En DDR5, el RCD emite cuatro señales de reloj de salida por lado en lugar de dos. Cada grupo de chips DRAM recibe su propia señal de reloj independiente. Este diseño reduce el ruido y mejora la fiabilidad a 5600 MT/s. Esta tecnología DDR5 RCD ofrece un aumento del 17 % en la velocidad de datos con respecto a la generación anterior. Se obtiene menor latencia y consumo de energía, con parámetros de temporización optimizados para mejorar los márgenes del módulo.CaracterísticaDDR4DDR5Relojes de salida por lado24Señales de reloj independientesNoSíMejora de la integridad de la señalLimitadoMejoradoEl RCD actúa como un chip clave del plano de control que distribuye señales de comando/dirección y reloj a los dispositivos DRAM. Su servidor se beneficia de una integridad de señal superior para las señales de comando/dirección y reloj. Este diseño RDIMM registrado ECC garantiza que la memoria de su servidor ECC funcione de manera confiable bajo cargas pesadas. Como módulo RDIMM registrado DDR5 ECC, esta memoria proporciona la estabilidad que necesita para aplicaciones empresariales. Estos módulos de memoria ECC ofrecen un rendimiento constante en entornos exigentes. Puede confiar en esto. Memoria ECC RDIMM para un rendimiento a largo plazo. Mejoras de rendimiento con memoria DDR5-5600MHz ECC Registered RDIMM Mayor ancho de banda para cargas de trabajo empresarialesLa memoria DDR5-5600 ECC RDIMM ofrece una velocidad de transferencia de datos de 5600 MT/s, también conocida como PC5-44800. Este rendimiento de alta velocidad de 5600 MHz (PC5-44800) elimina los cuellos de botella en las cargas de trabajo empresariales más exigentes. Obtendrá consultas de bases de datos más rápidas, operaciones de computación en la nube más fluidas y resultados de inferencia de IA más ágiles. El módulo DDR5 ECC registrado RDIMM gestiona transferencias de datos masivas sin ralentizar sus aplicaciones críticas. Este módulo de memoria DDR5 ECC registrado para servidores ofrece un ancho de banda de 5600 MHz (PC5-44800) que transforma las capacidades de su servidor. En entornos de virtualización, cada máquina virtual compite por los recursos de memoria. El módulo RDIMM DDR5-5600MHz ECC registrado proporciona el ancho de banda suficiente para que todas las máquinas virtuales funcionen sin problemas. Su hipervisor mantiene la estabilidad incluso bajo cargas pesadas. Las cargas de trabajo de computación de alto rendimiento (HPC) se benefician enormemente de este ancho de banda. Las simulaciones científicas, la modelización financiera y la secuenciación genómica requieren una rápida transferencia de datos. La memoria DDR5 ECC para servidores garantiza que sus procesadores nunca tengan que esperar por los datos. Los sistemas de almacenamiento también se benefician de esta velocidad. Se consiguen operaciones de lectura y escritura más rápidas en toda la infraestructura. La memoria DDR5 RDIMM funciona con una latencia CAS CL46. Esta especificación de temporización equilibra la velocidad y la capacidad de respuesta para aplicaciones empresariales. La memoria SK hynix DDR5-5600 ofrece estas ventajas de rendimiento a su centro de datos. Puede implementar esta memoria con total confianza en servidores de bases de datos, plataformas en la nube e infraestructuras de IA. Funcionamiento de bajo consumo a 1,1 V.La eficiencia energética es fundamental en los centros de datos empresariales. La memoria DDR5-5600MHz ECC Registered RDIMM funciona a tan solo 1,1 V. Este bajo voltaje reduce significativamente la generación de calor. Sus sistemas de refrigeración trabajan menos y sus costos de energía disminuyen. Logrará una mayor eficiencia en el uso de la energía en todas sus instalaciones. La densidad de 64 GB con configuración de rango 2Rx4 permite una escalabilidad rentable. Podrá equipar sus servidores con menos módulos y alcanzar una mayor capacidad total. Este módulo de memoria para servidores de alta capacidad reduce el espacio físico necesario y simplifica el mantenimiento. Cada RDIMM proporciona una memoria sustancial sin ocupar demasiado espacio en las ranuras.ParámetroEspecificaciónTasa de datos5600 MT/s (PC5-44800)Voltaje de funcionamiento1,1 VDensidad64 GBConfiguración de rango2Rx4Latencia CASCL46El diseño de memoria RDIMM registrada ECC también contribuye al ahorro de energía. El registro almacena en búfer las señales de comando y dirección, reduciendo la carga eléctrica en el controlador de memoria. Su sistema consume menos energía manteniendo la integridad de la señal. Esta arquitectura de memoria RDIMM registrada ECC resulta esencial para implementaciones de módulos de memoria de servidor de alta capacidad. Los entornos de virtualización, los clústeres HPC y los sistemas de almacenamiento se benefician de esta combinación. Obtendrá el rendimiento de la tecnología DDR5 con la fiabilidad de la protección ECC. El módulo DDR5 ECC Registered RDIMM admite las cargas de trabajo más exigentes. Su centro de datos funcionará de forma eficiente y ofrecerá el máximo rendimiento. Cómo la memoria ECC RDIMM valida la integridad de los datosValidación rigurosa de nivel empresarialLos servidores empresariales funcionan de forma continua, por lo que la memoria ECC RDIMM debe soportar un funcionamiento incesante. La memoria SK hynix DDR5-5600 se somete a pruebas de estrés de nivel de servidor que simulan las condiciones reales de un centro de datos. Estas pruebas someten los módulos a ciclos de rodaje prolongados, temperaturas extremas y tráfico de datos constante. El objetivo es simple: demostrar que cada módulo DDR5 ECC RDIMM registrado puede gestionar cargas de trabajo ininterrumpidas (24/7) sin fallos. El cumplimiento de la normativa JEDEC constituye la base de esta validación. El estándar común JEDEC DDR5 RDIMM abarca los requisitos eléctricos y mecánicos para módulos DIMM DDR5 registrados de 288 posiciones y 1,1 V. Sin embargo, el cumplimiento de la normativa JEDEC por sí solo no garantiza la compatibilidad universal con servidores. Aún así, conviene verificar varios factores:La validación del servidor depende de la generación de la CPU, el controlador de memoria, la BIOS, los módulos DIMM por canal, la organización de rangos y la calificación del proveedor.Compruebe el número de pieza del módulo comparándolo con la lista de proveedores cualificados del fabricante de su placa base o servidor.Seleccione módulos que hayan sido verificados como compatibles con JEDEC y que figuren en la lista de compatibilidad (QVL) del proveedor del servidor.Puede que aún sea necesaria la validación manual con respecto a la matriz de compatibilidad de memoria del modelo del servidor.Este enfoque por capas garantiza que su memoria DDR5 ECC ofrezca compatibilidad total con ECC en su plataforma específica. La arquitectura DDR5 ECC Registered RDIMM cumple con estándares estrictos, y los procesos de calidad de SK hynix confirman que cada módulo está listo para su implementación en entornos empresariales. Características de gestión térmica en el chipLas cargas de trabajo intensas generan calor en el servidor. El módulo DDR5 ECC Registered RDIMM soluciona este problema con sensores térmicos integrados. Estos sensores monitorizan la temperatura de los chips DRAM en tiempo real. Cuando la temperatura aumenta, el módulo activa la frecuencia de actualización adaptativa. Esta respuesta mantiene la estabilidad bajo cargas intensas sin sacrificar el rendimiento. El voltaje de funcionamiento de 1,1 V de este rdimm reduce la emisión térmica en comparación con alternativas de mayor voltaje. Gracias a la gestión térmica integrada, la memoria ECC para servidores se mantiene dentro de rangos de funcionamiento seguros. Obtendrá un rendimiento constante de 5600 MT/s incluso durante los períodos de máxima demanda. Esta gestión térmica inteligente protege su inversión y prolonga la vida útil del módulo. Su rdimm funciona de forma fiable gracias a que gestiona su propio perfil térmico. El diseño del rdimm registrado ECC integra estas medidas de seguridad a nivel de chip. Recibirá memoria ECC que protege activamente tanto los datos como el hardware. Compatibilidad de DDR5 RDIMM con plataformas empresarialesOptimizado para procesadores Intel y AMD.La elección de la plataforma del servidor determina si esta memoria funciona a máxima velocidad. El módulo DDR5-5600 ECC RDIMM se integra a la perfección con los procesadores Intel Xeon Scalable de cuarta y quinta generación. Las plataformas AMD EPYC Serie 9004 también validan este módulo para el funcionamiento con ECC registrado. Según la ficha del producto, la memoria SK hynix DDR5-5600 está validada para plataformas de servidor que admiten memoria ECC registrada, incluidas las plataformas AMD EPYC Serie 9004. Esto proporciona una amplia compatibilidad con el ecosistema en ambas familias de procesadores principales. La validación de la plataforma va más allá de la compatibilidad del socket. El controlador de memoria dentro de cada procesador gestiona la temporización, el voltaje y el comportamiento de actualización. Intel y AMD diseñan estos controladores según los estándares JEDEC DDR5. Su módulo DDR5 ECC registrado RDIMM cumple con esos mismos estándares. Esta compatibilidad garantiza un funcionamiento estable desde el primer arranque. Puede implementar esta memoria de servidor DDR5 ECC en flotas mixtas sin necesidad de ajustes específicos de la plataforma. Directrices para la población con memoriaLas instalaciones de alta capacidad requieren una planificación minuciosa antes de instalar los módulos. Primero, verifique la versión de su BIOS. Es posible que las versiones antiguas del firmware no reconozcan las densidades de 64 GB ni las configuraciones de rango 2Rx4. Actualice a la última versión del fabricante de su servidor. Este paso evita fallos de arranque y garantiza que su sistema aplique los parámetros de temporización correctos para un funcionamiento a 5600 MT/s. Siga las reglas de instalación de módulos DIMM adecuadas para su placa base. Estas reglas determinan el orden de las ranuras, el equilibrio de canales y la distribución de rangos. Instalar los módulos en la secuencia incorrecta puede provocar velocidades más bajas o impedir el arranque por completo. Consulte la Lista de Proveedores Calificados (QVL) de su proveedor de servidores antes de la compra. La lista recomienda verificar la QVL de la placa base para comprobar la compatibilidad exacta. Esta verificación confirma que sus módulos rdimm registrados con ECC cumplen con los requisitos probados por el proveedor. De esta forma, protege su implementación de problemas de compatibilidad inesperados y mantiene una protección ECC completa en todos los canales.  Sus servidores empresariales necesitan memoria que ofrezca un rendimiento excepcional en todos los aspectos. El módulo DDR5-5600 ECC RDIMM combina la fiabilidad de la memoria ECC y un diseño registrado, un rendimiento de 5600 MT/s con un bajo consumo de 1,1 V y una amplia compatibilidad con diversas plataformas. Este módulo DDR5 ECC RDIMM registrado no es un componente con una sola función, sino una solución integral para centros de datos modernos. Obtendrá mayor ancho de banda, mayor eficiencia energética y una escalabilidad mejorada en un solo módulo. La arquitectura registrada protege sus cargas de trabajo críticas. La memoria SK hynix DDR5-5600 satisface estas exigencias. Como responsable de TI, considere esta memoria DDR5 ECC como su estándar para nuevas implementaciones de servidores. Obtendrá mejoras inmediatas en el rendimiento y una escalabilidad de infraestructura a largo plazo. Elija memoria ECC para servidores y así impulsar su crecimiento. Preguntas frecuentes¿Qué distingue a esta memoria DDR5 de la memoria RAM estándar?Este módulo combina la corrección de errores ECC con un diseño registrado. Se obtiene integridad de datos y estabilidad de señal. La memoria RAM estándar carece de ambas características.¿Cómo protege ECC los datos de su empresa?La corrección electrónica de errores (ECC) corrige automáticamente los errores de memoria de un solo bit. Esto evita fallos del sistema y la corrupción de datos. Sus aplicaciones críticas se ejecutan sin interrupciones.¿Qué especificaciones técnicas definen este módulo de 64 GB?Las especificaciones técnicas clave de la memoria SK hynix DDR5-5600 incluyen una velocidad de 5600 MHz, una densidad de 64 GB y un rango 2Rx4. El módulo funciona a 1,1 V con una latencia CAS CL46.¿Cómo mejora la estabilidad del servidor un módulo RDIMM con certificación ECC?La arquitectura RDIMM registrada ECC almacena las señales en búfer mediante un chip RCD. Esto reduce la carga eléctrica en el controlador de memoria. Su servidor admite más módulos.¿Qué procesadores son compatibles con este módulo DDR5?Este módulo DDR5 es compatible con procesadores Intel Xeon Scalable y AMD EPYC. Ambas plataformas validan el funcionamiento de ECC registrado. Su implementación funciona en flotas de servidores mixtas.
  • Cómo elegir transceptores ópticos de alta velocidad para redes de centros de datos de IA
    Cómo elegir transceptores ópticos de alta velocidad para redes de centros de datos de IA
    September 20, 2026
    Elegir transceptores ópticos de alta velocidad Al combinar cinco aspectos con su red: velocidad, alcance, tipo de fibra, factor de forma y compatibilidad con conmutadores, el puerto más rápido rara vez es la mejor opción. Las cargas de trabajo de computación acelerada se benefician de una baja latencia, una alta densidad de puertos y presupuestos de energía predecibles. Empiece por la carga de trabajo y luego avance hacia afuera. Este orden permite seleccionar el transceptor de forma repetible y mantiene la velocidad del transceptor óptico vinculada a distancias de enlace reales, en lugar de a estrategias de marketing. Cada transceptor que se añade también modifica la alimentación del rack, la refrigeración y la infraestructura de cableado. Planifique la densidad y la migración con anticipación. Un socio confiable como X REACH LIMITED Suministramos óptica y cableado compatibles, para que su infraestructura se mantenga coherente a medida que crece. Conclusiones claveLa velocidad del transceptor debe coincidir con la función del puerto, no con el valor más alto. Utilice 100G para acceso, 400G para la red troncal y 800G para enlaces ascendentes.Para las nuevas implementaciones de IA, elija fibra monomodo. Reduce la cantidad de fibra a la cuarta parte y permite actualizaciones sin problemas a 800G.Pruebe cada módulo en modo de desacoplamiento antes de su implementación. La mayoría de los fallos se deben a limitaciones del firmware, especialmente en las divisiones de 800G a 4x100G.Calcula el consumo de energía por puerto para cada rack. Los módulos de 800G añaden entre 14 y 18 W, lo que aumenta la carga térmica entre 1,5 y 2 veces. SNiveles de velocidad para transceptores ópticos de centros de datos de IA de alta velocidadComparación de 100G, 400G y 800GCada nivel de velocidad cumple una función específica en la estructura. Se implementan 100G en el nodo leaf para el acceso a servidores y los enlaces de administración. Se colocan 400G en el nodo spine y para la interconexión de GPU dentro de un rack. Se reservan 800G para los enlaces ascendentes spine y los enlaces troncales entre pods que transportan tráfico agregado. La mejor opción se ajusta a la carga de trabajo, el tipo de puerto y la distancia del enlace. La velocidad bruta por sí sola no aporta mucha información. Un puerto de 400 Gbps con un alcance de 500 metros resuelve un problema diferente al de uno con un alcance de 2 kilómetros.TransceptorFibra / ConectorAlcance máximo400G-DR4Monomodo / MPO-12500 metros400G-FR4LC monomodo/dúplex2 kmEsa separación es importante. Se elige DR4 para tramos en fila y en filas adyacentes. Se elige FR4 cuando el enlace cruza un pasillo. La velocidad del transceptor óptico se mantiene constante en ambos casos, pero el alcance determina qué módulo se ajusta mejor a la disposición. Por qué los tejidos con IA impulsan el desarrollo de 800G y 1,6T.El entrenamiento de IA cambia las reglas del juego en cuanto al ancho de banda. Una sola ejecución de entrenamiento de clase GPT puede saturar enlaces de 100 Gbps miles de veces. Los clústeres de GPU de NVIDIA conectan más de 100 000 aceleradores en una sola red. Cada GPU requiere entre 400 y 800 Gbps de ancho de banda de interconexión. La capacidad agregada alcanza los 80 petabits por segundo en un clúster de este tipo.El entrenamiento de la IA requiere 800 GB en la actualidad y 1,6 TB para 2026, mientras que 400 GB eran suficientes para las cargas de trabajo generales en la nube.La comunicación con el servidor de parámetros para la sincronización de gradientes, por sí sola, requiere de 3 a 5 Tb/s. Todas las operaciones de reducción necesitan acceso simultáneo de alta velocidad a cada nodo. El almacenamiento de puntos de control y la alimentación de la canalización de datos añaden una carga continua. Transceptores ópticos de alto ancho de banda Absorber esta presión aumentando el número de carriles por módulo. El lanzamiento del modelo de 1,6 toneladas sigue una secuencia clara:2025-2026: Despliegue inicial y aumento gradual del volumen, concentrado en clústeres de entrenamiento de IA y capas troncales de alta capacidad.2026-2027: Mayor adopción de la arquitectura de IA, aunque seguirán siendo comunes los entornos mixtos de 400G/800G/1,6T.2027 y más allá: La hoja de ruta apunta hacia módulos de 3,2 T, con OSFP-XD posicionado para una mayor densidad de carriles.El dinamismo de los proveedores confirma el cambio. Marvell lanzó su DSP PAM4 de 3 nm Ara 1.6T en grandes volúmenes en marzo de 2026. Cisco anunció sistemas Silicon One G300 con 64 puertos capaces de operar a 1.6T. Arista anunció plataformas de 64 puertos a 1.6T en la familia 7060XE7. Las primeras implementaciones de 1.6T tuvieron precios elevados, superiores a los 3000 dólares por unidad. Los estándares aún están por detrás del hardware. A julio de 2026, la norma IEEE P802.3dj seguía en la versión preliminar 3.1. Su publicación final está pendiente. Por lo tanto, sus especificaciones de adquisición deben distinguir entre "diseñado según el borrador actual de P802.3dj" y el cumplimiento con la norma final publicada. La revisión 5.1 de OSFP MSA incluye disposiciones para OSFP1600, y la OIF publicó CMIS 5.4 en mayo de 2026. Planifique su infraestructura en función de este ritmo. Adquiera 800G para los clústeres de IA actuales y confirme que el silicio y el cableado de sus conmutadores admiten una futura actualización a 1,6T. Este enfoque protege su inversión en infraestructura y mantiene la eficiencia a medida que aumenta el tráfico de red. Transceptores de alcance, fibra y ópticos para redes de centros de datosClases de alcance SR, DR, FR y LRLa clase de alcance indica hasta dónde puede llegar un enlace. A 400G, las cuatro clases comunes cubren distancias muy diferentes.Tipo de transceptorDistancia máxima admitidaFibra/Medio400G SR8100 metrosMultimodo OM3 (MPO-16, 850 nm)400G DR4500 metrosMonomodo (MPO-12, 1310 nm)400 g FR42 kmMonomodo (LC dúplex, CWDM)400G LR410 kmMonomodo (LC dúplex, CWDM)Se elige SR8 para tendidos dentro de racks de menos de 100 metros. DR4 gestiona las conexiones entre cables principales y secundarios dentro de una misma sala. FR4 y LR4 se utilizan para trayectos más largos, incluyendo tramos entre edificios. Transceptores ópticos de larga distancia Módulos como el LR4 transportan tráfico a través de un campus sin necesidad de regeneración. Arquitectura monomodo frente a multimodo y MPOActualmente, la fibra monomodo predomina en las nuevas configuraciones de IA. Con una velocidad de 400 Gbps, el SR8 utiliza 16 fibras a través de un conector MPO-16. El DR4 utiliza un conector MPO-12, cubriendo 500 metros mediante fibra monomodo. Esta reducción en el número de fibras disminuye el volumen del cable y simplifica la arquitectura MPO. El costo también influye en la decisión. Un módulo SR8 de 400G cuesta alrededor de $219, y un DR4 de 400G, alrededor de $549. La tecnología multimodo resulta más económica a corto plazo para enlaces cortos. La tecnología monomodo es la mejor opción para el crecimiento futuro. El punto de inflexión se sitúa entre los 200 y 250 metros para implementaciones de 100G. Más allá de esa distancia, la tecnología monomodo se vuelve técnicamente necesaria y, a la larga, más económica. La selección del transceptor determina la escalabilidad de la topología. Las actualizaciones monomodo a 800G DR8 se logran duplicando los carriles. Las redes multimodo no ofrecen una ruta directa a 800G sin nuevos enlaces MPO-16. Planifique su infraestructura de fibra una sola vez y evitará costosos proyectos de recableado en el futuro. Factor de forma y compatibilidad de interruptoresQSFP-DD, OSFP y QSFP112El factor de forma determina la cantidad de ancho de banda que cabe en un panel frontal y la cantidad de calor que genera cada puerto. QSFP-DD es un factor de forma común para módulos de 400G, mientras que OSFP está diseñado para 800G y 1.6T, con soporte definido en la revisión 5.1 de OSFP MSA. QSFP112 es otro factor de forma de 400G que utiliza menos carriles, pero más rápidos. Asegúrese de que el factor de forma sea compatible con el ASIC de su switch y su diseño de refrigeración antes de tomar una decisión. Comprobaciones de puertos, desvíos e interoperabilidadLa función Breakout convierte un puerto de 400G en cuatro enlaces de 100G. Este patrón es ideal para la configuración spine-to-leaf, la expansión de clústeres de GPU y la migración gradual de 100G a 400G. Se requiere el perfil de puerto de switch adecuado, arneses de Breakout MPO, óptica remota compatible y una asignación de carriles precisa. Valide cada módulo con la matriz de compatibilidad del fabricante del switch para su SKU y versión de software específicos. Confirme la clase de potencia y verifique que las versiones CMIS coincidan entre el firmware del switch y el transceptor. Pruebe primero los modos de desacoplamiento en un laboratorio. Los módulos de bajo costo suelen funcionar correctamente a 400G nativos y luego fallan durante el desacoplamiento debido a limitaciones del firmware o del mapeo de carriles.La compatibilidad varía según el fabricante y el módulo. Considere la selección del transceptor como una cuestión de compatibilidad, no como una competición de velocidad, y su red de IA se conectará correctamente al primer intento. Alimentación, refrigeración y fiabilidad en redes de IAPresupuestos de energía y térmicos por puertoUna mayor velocidad del transceptor óptico genera más calor por módulo. Los módulos de 800G consumen más energía que los de 400G, lo que modifica el presupuesto de su rack. Por bit transmitido, 800G es más eficiente, lo que impulsa la migración entre clústeres de IA. Sin embargo, cada módulo sigue generando calor que debe disiparse. La capacidad de refrigeración ahora limita la densidad del rack. Pasar de una potencia por puerto de 400 G a 800 G aumenta la carga térmica del rack, por lo que la refrigeración diseñada para 400 G puede no ser suficiente para 800 G. Riesgos derivados del polvo, el calor y el estrés mecánico.Los racks de IA alcanzan altas densidades de potencia. Las temperaturas de las GPU se mantienen elevadas durante largos periodos. Los transceptores ópticos de la red del clúster de GPU deben soportar estas condiciones. Los diseños de escape del lado del puerto generan estrés térmico, y el flujo de aire inestable reduce el margen de enlace.Efecto de la temperaturaImpacto en el rendimiento ópticoImplicaciones en la fiabilidadTemperatura elevadaPotencia óptica de salida reducidaEstabilidad del margen del enlace inferiorfluctuación de temperaturaMayor variación de la señal y fluctuaciónMayor riesgo de BERControl térmico estableRendimiento óptico constanteVida útil prolongada del móduloEl calor también modifica la longitud de onda del láser. En los sistemas WDM, esta variación puede hacer que la señal quede fuera de la ventana de filtrado del receptor. En consecuencia, la tasa de error de bits (BER) aumenta y el enlace puede perderse por completo. El polvo y el estrés mecánico agravan el problema. Las caras de los extremos de MPO contaminadas dispersan la luz y reducen el margen de seguridad. La inserción repetida desgasta las férulas de los conectores. La óptica de alta calidad reduce las fallas causadas por el polvo, el calor y el estrés, protegiendo su infraestructura y su rendimiento durante años de servicio. Marco de selección y errores comunesOrden de selección paso a pasoUn orden repetible mantiene la selección del transceptor basada en su tejido en lugar de en una hoja de especificaciones. Siga estos pasos en secuencia:Defina la carga de trabajo. Identifique si el enlace sirve para interconexión de GPU, agregación de la red troncal o almacenamiento. Los clústeres de entrenamiento de IA prefieren enlaces cortos, densos y de baja latencia.Configure la velocidad. Adapte el ancho de banda a la función del puerto, no al valor máximo disponible.Defina el alcance. Mida la longitud real de la fibra. Elija SR8 para fibra multimodo de hasta 100 m, DR8 para fibra monomodo de hasta 500 m y FR4 para fibra monomodo de hasta 2 km.Confirme la infraestructura de fibra óptica. El cambio entre fibra multimodo y monomodo incrementa considerablemente el coste de despliegue.Seleccione el formato. Verifique la compatibilidad con OSFP u OSFP-XD con el ancho de banda del ASIC de su conmutador.Validar la compatibilidad. Consultar la lista de proveedores, confirmar la codificación de la EEPROM y realizar pruebas en hardware real antes del despliegue a gran escala.Presupuesto de energía y refrigeración. Sume la potencia por puerto en cada puerto del rack.Planifique tener repuestos. Mantenga un número moderado de repuestos por cada tipo de óptica.Esta secuencia protege su presupuesto de infraestructura y su cronograma de implementación. Escollos que hacen fracasar las implementaciones de IAEl módulo más barato de una cotización suele ser el más caro a largo plazo. Comprar módulos LR4 para un enlace de 1 km implica cubrir una distancia que la red nunca utiliza y aumenta el consumo de energía en cada puerto. El error inverso también es perjudicial. Un módulo DR4 en un tramo de entre 700 y 1000 metros puede obligar a rediseñar el sistema o a realizar reemplazos de emergencia una vez que se agota el margen de seguridad. El consumo de energía agrava este problema. Incluso un pequeño aumento de potencia se multiplica en cientos de puertos. Los errores de cableado son igualmente comunes. Presta atención a estos:Tipo de conector MPO incorrecto. SR8 necesita MPO-16, DR4 necesita MPO-12.Desajuste de polaridad.Conectores APC y UPC compatibles.Género del conector incorrecto. Los transceptores usan conectores MPO macho. Los cables de conexión deben usar conectores hembra.Cableado de derivación inadecuado para enlaces de 800G.Mala planificación de la duración.El riesgo de suministro merece la misma atención. Un diseño que depende de un módulo codificado de un solo proveedor puede paralizar toda una producción cuando la disponibilidad de DSP, láseres EML o capacidad de empaquetado se reduce. La cualificación de múltiples proveedores y una política de repuestos definida disminuyen este riesgo.Los costes derivados del tiempo de inactividad hacen que estos inconvenientes sean reales. Un clúster de 1000 GPU con óptica de baja calidad puede sufrir pérdidas significativas. Los transceptores ópticos para centros de datos de larga distancia y los transceptores ópticos para redes de clústeres de GPU presentan distintos modos de fallo. Los transceptores ópticos para centros de datos de alto ancho de banda requieren una planificación cuidadosa. La selección del transceptor debe considerarse una decisión que abarca todo su ciclo de vida. Su infraestructura, rendimiento y eficiencia dependen de ello.  Adapte la velocidad, el alcance, la fibra, el formato, la compatibilidad y el ajuste operativo a su infraestructura. Esta secuencia garantiza que los transceptores ópticos de alta velocidad para centros de datos con IA se ajusten a las necesidades reales de la carga de trabajo. Las redes de IA premian la planificación anticipada. La densidad, la potencia y las rutas de migración merecen atención antes de comprar. Las compras puntuales aumentan el costo y el riesgo en toda la infraestructura. Valida cada componente óptico con la lista de compatibilidad del fabricante de tu conmutador. Busca un proveedor fiable para garantizar la calidad y el suministro constantes. Una planificación cuidadosa protege tu infraestructura y mantiene la eficiencia de tu red a medida que crece. Preguntas frecuentes¿Qué velocidad debería elegir primero para un tejido con inteligencia artificial?Comience por definir la función del puerto. Utilice 100G para el acceso al servidor, 400G para los enlaces de la red troncal y las GPU en el rack, y 800G para los enlaces ascendentes de la red troncal y los enlaces troncales entre pods. Adapte el ancho de banda a la carga de trabajo en lugar de buscar el valor más alto en la hoja de datos.¿Cómo elegir entre SR8, DR4, FR4 y LR4?Mida la longitud real de la fibra. SR8 cubre enlaces multimodo de hasta 100 m. DR4 alcanza los 500 m en fibra monomodo. FR4 y LR4 se extienden hasta 2 km y 10 km, respectivamente. Los transceptores ópticos para centros de datos de larga distancia, como LR4, cubren tramos de campus sin regeneración.¿Por qué la fibra monomodo predomina en las nuevas construcciones de IA?La fibra monomodo predomina en las nuevas implementaciones de IA debido a su mayor alcance y ancho de banda. A 400G, DR4 utiliza un conector MPO-12, mientras que SR8 utiliza un conector MPO-16, por lo que la fibra monomodo reduce el volumen del cable. Además, la fibra monomodo se actualiza fácilmente a 800G DR8.¿Qué es lo que suele provocar fallos en los enlaces de derivación de 800G?La mayoría de los fallos se deben a limitaciones en el firmware y la asignación de carriles. Un módulo que funciona correctamente a 400 Gbps puede fallar durante la configuración a 4x100 Gbps. Confirme el perfil del puerto del switch, utilice el arnés MPO correcto y pruebe los modos de configuración en un laboratorio antes de escalar.¿Cuánta potencia y calor añade cada puerto?Los módulos de 800G consumen más energía que los de 400G, por lo que pasar de 400G a 800G aumenta la carga térmica del rack. Sume la potencia por puerto en cada puerto y, a continuación, confirme que su sistema de refrigeración soporta el consumo total.¿Por qué planificar repuestos y la cualificación de múltiples proveedores?El tiempo de inactividad de las GPU puede resultar costoso. Un clúster de 1000 GPU con una tasa significativa de fallos en la óptica puede perder muchas horas. La cualificación de múltiples proveedores y un conjunto definido de repuestos protegen su infraestructura de la escasez de suministro y del riesgo de depender de un único proveedor. Una planificación cuidadosa mantiene la eficiencia de la infraestructura a medida que crece.
  • ¿Por qué la RTX 5090 es la mejor GPU para juegos e IA?
    ¿Por qué la RTX 5090 es la mejor GPU para juegos e IA?
    September 17, 2026
    La RTX 5090 se erige como la mejor GPU para juegos e IA. Obtienes una potencia inigualable de la NVIDIA GeForce RTX 5090y ninguna otra GPU se le acerca. Esta tarjeta gráfica insignia para juegos ofrece tres pilares de dominio. Primero, la enorme capacidad de procesamiento de 21 760 núcleos CUDA impulsa las velocidades de fotogramas. Segundo, DLSS 4.5 con Multi-Frame Generation mejora los títulos 4K con trazado de rayos hasta en un 35 %, según las pruebas de NVIDIA. Tercero, 32 GB de GDDR7 aceleran el entrenamiento de modelos. Las especificaciones de la RTX 5090 incluyen PCIe 5.0 x16 y DisplayPort 2.1. Este rendimiento establece un nuevo estándar. Las pruebas de rendimiento, las especificaciones y las comparaciones directas respaldan cada afirmación. Esta GPU redefine lo que una tarjeta gráfica puede lograr, y ninguna otra GPU la iguala. Conclusiones claveLa RTX 5090 domina el mundo de los videojuegos con 21.760 núcleos CUDA y DLSS 4.5, ofreciendo una experiencia de juego fluida en 4K y 8K.Sus 680 núcleos Tensor y 32 GB de memoria GDDR7 aceleran el entrenamiento y la inferencia de la IA, manejando modelos grandes con facilidad.Obtendrás un 78 % más de ancho de banda de memoria que con la RTX 4090, lo que acelera las tareas que requieren gran cantidad de datos, como el entrenamiento de modelos y la edición de vídeo en 8K.La tarjeta requiere una fuente de alimentación de 950 W debido a su consumo de energía de 575 W, así que planifique utilizar una fuente de alimentación robusta.Actualiza si necesitas el máximo rendimiento para juegos, inteligencia artificial o trabajo profesional; no lo hagas si juegas a 1080p.Rendimiento en juegos de la RTX 5090  Potencia bruta y puntos de referenciaLa arquitectura Blackwell impulsa cada fotograma que renderizas en la RTX 5090. En su núcleo, encontramos 21 760 núcleos CUDA y 170 núcleos RT de cuarta generación. Estas cifras representan un aumento aproximado del 33 % con respecto al modelo insignia anterior. La tabla a continuación muestra la comparación directa.EspecificaciónRTX 5090RTX 4090Núcleos CUDA21.76016.384Núcleos RT170128Este salto en el hardware bruto se traduce directamente en los benchmarks de juegos. En 3DMark Port Royal, una prueba centrada en el trazado de rayos, la RTX 5090 obtiene una puntuación de 46.823 con un Intel Core i9-14900K. Una segunda entrada con un AMD Ryzen 9 9950X3D alcanza los 46.808. En Time Spy Extreme, un benchmark DirectX 12 a resolución 4K, la tarjeta registra 26.815 con el Ryzen 9 9950X3D. Estos resultados colocan a la GPU en lo más alto de la clasificación del Salón de la Fama. Obtendrás una jugabilidad fluida en 4K en todos los títulos modernos. A 8K, la tarjeta mantiene velocidades de fotogramas jugables en motores exigentes. Las especificaciones de la RTX 5090 incluyen PCIe 5.0 x16 para una latencia ultrabaja. Las salidas DisplayPort 2.1 y HDMI 2.1 admiten monitores 4K y 8K de alta frecuencia de actualización. Esta conectividad garantiza que la pantalla nunca limite el rendimiento del procesador gráfico. Ray Tracing y DLSS 4.5El trazado de rayos en esta GPU alcanza nuevas cotas. Los 170 núcleos RT de cuarta generación gestionan el trazado de rayos en tiempo real con una eficiencia excepcional. Disfrutarás de iluminación, sombras y reflejos fotorrealistas en los juegos compatibles. La RTX 5090 combina este hardware con DLSS 4.5 y Generación Multifotograma. Esta tecnología inserta fotogramas adicionales entre los renderizados. Como resultado, la velocidad de fotogramas en títulos exigentes aumenta significativamente. NVIDIA DLSS 4.5 está diseñado para funcionar con una amplia variedad de juegos. Se activa en la configuración y mejora el rendimiento sin comprometer significativamente la calidad visual. La combinación de un potente hardware RT y DLSS convierte el trazado de rayos 4K en una opción viable. La GeForce RTX 5090 también se beneficia de un alto ancho de banda de memoria. Sus 32 GB de VRAM GDDR7 en un bus de 512 bits ofrecen hasta 1792 GB/s. Este ancho de banda de memoria alimenta la GPU con datos rápidamente. Un alto ancho de banda de memoria es crucial para texturas grandes y escenas complejas. La tarjeta mantiene una entrega de fotogramas constante gracias a esta ventaja en el ancho de banda de memoria. Para juegos competitivos, PCIe 5.0 x16 reduce aún más la latencia. Reaccionas más rápido en títulos de ritmo acelerado. La RTX 5090 ofrece una experiencia de juego inigualable. Su rendimiento en pruebas de rendimiento reales en juegos con trazado de rayos establece el estándar. Cada prueba de rendimiento confirma el dominio de la tarjeta en el mundo de los videojuegos. Rendimiento y cargas de trabajo de la IA de NVIDIA  Núcleos Tensor y 32 GB de GDDR7La RTX 5090 transforma las cargas de trabajo de IA a través de sus Tensor Cores de quinta generación. Estas unidades especializadas aceleran las operaciones matriciales en el corazón de cada red neuronal. Obtendrás 32 GB Memoria VRAM GDDR7 en un bus de 512 bits, una configuración que maneja conjuntos de datos masivos sin necesidad de usar la memoria del sistema. El ancho de banda de la memoria alcanza los 1792 GB/s. Compárese con los 1008 GB/s de la RTX 4090. Se obtiene un aumento del 78 % en el ancho de banda de la memoria. Esta ventaja es crucial al entrenar modelos de lenguaje complejos o procesar imágenes de alta resolución. La GeForce RTX 5090 envía datos a sus núcleos CUDA a una velocidad extraordinaria. El entrenamiento de tu modelo se completa más rápido porque la GPU nunca espera datos. La memoria VRAM GDDR7 de 32 GB también admite inferencias en modelos que superan los 24 GB. Puedes ejecutar lotes más grandes y lograr un mayor rendimiento. La computación científica también se beneficia de este ancho de banda de memoria. Las simulaciones en dinámica de fluidos o modelado molecular requieren un acceso rápido a los datos. La RTX 5090 proporciona ese acceso de forma constante. La protección contra pérdida de energía del hardware añade una fiabilidad de nivel empresarial. Tus largas sesiones de entrenamiento sobreviven a cortes de energía inesperados sin que se corrompan los datos. Esta característica diferencia a la RTX 5090 de las GPU de consumo. Ecosistema de software y puntos de referencia de IANVIDIA mantiene el ecosistema CUDA como el estándar de la industria para el desarrollo de IA. Tendrá acceso a bibliotecas optimizadas para aprendizaje profundo, visión artificial y computación científica. Frameworks populares como PyTorch y TensorFlow se ejecutan de forma nativa en esta plataforma. La GPU acelera el entrenamiento, la inferencia y el ajuste fino de modelos. Las pruebas de rendimiento en el mundo real confirman la ventaja de rendimiento. En el entrenamiento de ResNet-50, la RTX 5090 procesa 1128,6 muestras por segundo con precisión FP32. La RTX 4090 gestiona 757,5 muestras por segundo. Con precisión FP16, la RTX 5090 alcanza las 1623,9 muestras por segundo. El modelo insignia anterior ofrece 1360,6 muestras por segundo. Estos resultados muestran mejoras consistentes en todos los modos de precisión. Sus pipelines de aprendizaje profundo finalizarán más rápido. La GPU también destaca en cargas de trabajo de inferencia. Implementará modelos entrenados con menor latencia. Las aplicaciones de computación científica se benefician de la misma arquitectura. Los investigadores ejecutan simulaciones que antes requerían múltiples unidades GPU. El ecosistema CUDA admite estas cargas de trabajo con herramientas maduras. Encontrará documentación, soporte de la comunidad y asistencia empresarial fácilmente disponibles. La tecnología DLSS también aprovecha los Tensor Cores para juegos. Este diseño de doble propósito hace que la RTX 5090 sea valiosa tanto para la investigación en IA como para el entretenimiento. La GPU maneja con eficiencia el renderizado 3D profesional y la producción CGI. Los editores de video logran la reproducción en 8K en tiempo real. Los estudios de producción virtual confían en este rendimiento para gemelos digitales. La GPU cumple con los estándares de confiabilidad empresarial. La protección contra pérdida de energía del hardware garantiza que su trabajo sobreviva a las interrupciones de energía. La RTX 5090 se erige como la opción definitiva para los profesionales de IA que exigen el máximo rendimiento.¿Cómo se compara esta GPU con sus rivales? En comparación con los buques insignia de la generación anteriorLas mayores mejoras se aprecian al comparar la RTX 5090 con la RTX 4090. La tarjeta más reciente cuenta con 21 760 núcleos CUDA frente a los 16 384 de la anterior, y sus 32 GB de memoria GDDR7 duplican los 24 GB de la memoria intermedia. El ancho de banda de la memoria aumenta de 1008 GB/s a 1792 GB/s, un incremento del 78 %. Este mayor ancho de banda permite procesar modelos de lenguaje complejos y texturas 8K sin interrupciones. En el entrenamiento de ResNet-50, la RTX 5090 alcanza 1128,6 muestras por segundo en FP32, mientras que la RTX 4090 llega a 757,5. El entrenamiento se completa antes y la latencia de inferencia disminuye. El consumo de energía es similar. Las especificaciones de la RTX 5090 indican un consumo de 575 W, frente a los 450 W de la RTX 4090. En juegos, la tarjeta más reciente consume 685 W, en comparación con los 610 W de la anterior. Los picos transitorios máximos alcanzan los 1150 W, frente a los 850 W de la anterior. Necesitas una fuente de alimentación de 950 W, no la de 850 W que recomienda el modelo insignia anterior.La RTX 5090 tiene una potencia nominal de 575 W, frente a los 450 W de la RTX 4090, lo que representa un aumento significativo en el consumo de energía junto con una mejora en el rendimiento. Frente a los competidores de la generación actualLa RX 7900 XTX de AMD consume 355 W a plena carga y requiere una fuente de alimentación de 800 W. La RTX 5090 consume más energía, pero ofrece un rendimiento muy superior en juegos y tareas de IA. Su ecosistema CUDA le otorga una ventaja de software sin igual. Las cargas de trabajo profesionales, como el renderizado 3D y la producción de CGI, se ejecutan más rápido con esta GPU.El precio de la RTX 5090 refleja esta diferencia. El desembolso inicial es mayor, y este coste se extiende a la refrigeración y la alimentación. Una carcasa robusta y una fuente de alimentación de 950 W de alta calidad incrementan el precio total. Aun así, ninguna otra GPU de la competencia ofrece los mismos resultados en las pruebas de rendimiento. La RTX 5090 se consolida como la tarjeta gráfica de gama alta para quienes buscan el máximo rendimiento.  La RTX 5090 se ha ganado su título como la mejor GPU para juegos e IA. La evidencia se ve en cada prueba de rendimiento. La NVIDIA GeForce RTX 5090 ofrece velocidades de fotogramas inigualables en 4K y 8K. Sus 32 GB de GDDR7 aceleran el entrenamiento de modelos. Esta GPU es ideal para jugadores de 4K y 8K, investigadores de IA, creadores de contenido y usuarios de estaciones de trabajo. Si juegas a 1080p, quizás no te convenga esta GPU. Su precio refleja su estatus de gama alta. También necesitas una fuente de alimentación de 950 W. La GPU de NVIDIA establece el estándar para las futuras generaciones. Ninguna otra GPU iguala este rendimiento. Las mejores tarjetas gráficas seguirán el ejemplo de esta GPU. El precio de entrada es elevado. Preguntas frecuentes¿Qué fuente de alimentación necesitas para la RTX 5090?Necesitas una fuente de alimentación de 950 W. La tarjeta consume 575 W bajo carga, y los picos transitorios alcanzan niveles más altos. Una fuente de calidad con una entrega robusta evita la inestabilidad. La RTX 5090 requiere mayor margen de potencia que los modelos insignia anteriores.¿Cómo ayudan los 32 GB de VRAM a las cargas de trabajo de IA?Puedes ejecutar modelos de mayor tamaño sin necesidad de usar la memoria del sistema. Los 32 GB de VRAM permiten manejar modelos de lenguaje complejos y conjuntos de datos de alta resolución. El entrenamiento se completa más rápido gracias al rápido acceso de la GPU a los datos. Esta capacidad admite inferencias en modelos que superan los 24 GB.¿Mejora DLSS 4.5 el rendimiento en los juegos?Sí. DLSS 4.5 con Generación de Multifotogramas inserta fotogramas adicionales entre los renderizados. La velocidad de fotogramas aumenta significativamente en títulos exigentes. Se activa en la configuración y se obtiene un trazado de rayos 4K fluido. Esta tecnología funciona con una amplia variedad de juegos.¿Deberías actualizar tu tarjeta gráfica RTX 4090?Obtendrás un 78 % más de ancho de banda de memoria y aproximadamente un 33 % más de núcleos CUDA. La GPU de Nvidia entrena los modelos más rápido y renderiza contenido 8K con fluidez. El precio inicial es elevado y necesitarás una nueva fuente de alimentación. Actualiza si exiges el máximo rendimiento.¿Esta GPU es compatible con cargas de trabajo profesionales?Sí. La GPU de Nvidia gestiona el renderizado 3D, la producción de CGI y la edición de vídeo 8K en tiempo real. La protección contra pérdida de energía por hardware aporta fiabilidad para entornos empresariales. El ecosistema CUDA admite el aprendizaje profundo y la computación científica. Esta GPU satisface las exigencias de las estaciones de trabajo.
  • ¿Qué es un SSD y cómo funciona en 2026?
    ¿Qué es un SSD y cómo funciona en 2026?
    September 03, 2026
    Pulsas el botón de encendido. Tu antiguo ordenador tarda un minuto en llegar al escritorio. El nuevo está listo en segundos. ¿Te has preguntado por qué? La respuesta está en el almacenamiento. Tu nuevo equipo utiliza una SSD, una unidad de estado sólido. Este tipo de almacenamiento se basa en chips de memoria, no en piezas móviles. La antigua comparación entre discos duros y SSD pone de manifiesto este cambio. Un disco duro (HDD) utiliza platos giratorios. Una SSD almacena los datos en memoria flash, lo que la hace más rápida y fiable. Esta diferencia de velocidad es abismal. La tabla siguiente muestra los tiempos de arranque típicos.SistemaTiempo de arranque del disco duro (segundos)Tiempo de arranque de la unidad SSD (segundos)Windows 1160–9012–17Linux Ubuntu45–708–15Esta mejora en el rendimiento se debe al diseño de estado sólido. Al no tener piezas móviles, se reduce la latencia. Obtendrá acceso instantáneo a sus archivos.Conclusiones claveLas unidades SSD utilizan memoria flash, no piezas móviles, por lo que son más rápidas y fiables que los discos duros tradicionales (HDD).Elige una unidad SSD NVMe para obtener la máxima velocidad, especialmente para juegos o tareas exigentes.Las unidades SSD son silenciosas, duraderas y consumen menos energía, lo que las hace ideales para ordenadores portátiles.Actualiza a una unidad SSD para obtener tiempos de arranque más rápidos y un mejor rendimiento general.Al elegir una unidad SSD, tenga en cuenta sus necesidades y su presupuesto, ya que cuestan más por gigabyte que los discos duros tradicionales (HDD).Cómo las unidades de estado sólido almacenan datosMemoria flash NAND: Las celdas de almacenamiento digitalLas unidades de estado sólido utilizan memoria flash no volátil. Esto significa que los datos permanecen intactos al apagar el ordenador. Imagina una vasta red de pequeñas celdas. Cada celda, llamada celda NAND, contiene una carga eléctrica. Dicha carga representa los datos en código binario: unos y ceros. La presencia o ausencia de carga determina el valor almacenado.No todas las celdas almacenan la misma cantidad de datos. Los fabricantes clasifican la memoria NAND según la cantidad de bits que almacena cada celda. La siguiente tabla muestra los tipos más comunes que encontrará en 2026.Tipo de célulaBits por celdaSLC1MLC2TLC3QLC4Más bits por celda significan menor costo y mayor capacidad. Sin embargo, esta densidad tiene un costo que reduce la durabilidad. Cada celda solo puede soportar un número limitado de ciclos de programación/borrado antes de desgastarse. La siguiente tabla muestra los rangos de durabilidad típicos.Tipo NANDBits por celdaDuración típica (ciclos de programación/borrado)SLC150.000 – 100.000MLC23.000 – 10.000TLC31.000 – 3.000QLC4150 – 1.000Las unidades modernas superan las limitaciones de durabilidad gracias a la arquitectura 3D NAND. En lugar de colocar las celdas planas en un solo plano, los fabricantes las apilan verticalmente en capas. Este enfoque aumenta drásticamente la capacidad sin reducir el tamaño de las celdas individuales. Una unidad de 2,5 pulgadas ahora puede almacenar más de 1 TB de datos. El diseño vertical también reduce la interferencia electrónica, lo que mejora la fiabilidad en comparación con los diseños planares anteriores.El controlador: el cerebro de la unidad SSDLas celdas NAND almacenan tus datos, pero el controlador lo gestiona todo. Este pequeño procesador actúa como director de tráfico para todas las operaciones de almacenamiento SSD. Se comunica con la memoria RAM de tu ordenador y traduce las solicitudes en acciones físicas sobre la memoria flash.El controlador realiza varias tareas críticas para mantener el rendimiento de la unidad SSD:Capa de traducción instantánea (FTL): Traduce las direcciones de bloques lógicos de su sistema operativo a ubicaciones físicas de la memoria NAND.Nivelación del desgaste: Distribuye los ciclos de escritura/borrado de manera uniforme en todos los bloques para evitar el desgaste prematuro en cualquier área en particular.Recogida de basura: Consolida los datos válidos de los bloques parcialmente llenos y borra los bloques antiguos para recuperar espacio durante los periodos de inactividad.Código de corrección de errores (ECC): Detecta y corrige los errores de bits que se producen a medida que la memoria flash se degrada con el tiempo.Comando TRIM: Informa a la unidad qué bloques de datos ya no son necesarios, lo que permite una recolección de basura eficiente.El controlador también gestiona la transferencia de datos entre el sistema anfitrión y el almacenamiento NAND. Al guardar un archivo, el controlador recibe la orden con una dirección de bloque lógico. A continuación, traduce esa dirección a una ubicación de página física. Dado que la memoria NAND no puede sobrescribir los datos directamente, el controlador asigna una nueva ubicación para los datos actualizados y actualiza su tabla de asignación. Este proceso se realiza en milisegundos.La ausencia de partes móviles en las unidades de estado sólido elimina la latencia mecánica. Su sistema accede a los datos casi instantáneamente. Este diseño también elimina el riesgo de fallas mecánicas por caídas o golpes en los dispositivos. Los controladores modernos incluso programan tareas en segundo plano de forma inteligente, lo que garantiza que la recolección de basura no interfiera con sus cargas de trabajo activas. Ya sea que utilice una unidad de consumo para juegos o una SSD NVMe empresarial como el Solidigm D7-P5520 Para los centros de datos, el controlador garantiza un rendimiento constante. Incluso aplicaciones exigentes como las que se ejecutan en un NVIDIA GeForce RTX 5090 Benefíciese del rápido acceso a la memoria flash.SSD SATA: La actualización universalLas unidades SSD SATA representan la opción más accesible para acceder al almacenamiento de estado sólido. Estas unidades utilizan la misma interfaz que los discos duros tradicionales, lo que las hace compatibles con prácticamente cualquier ordenador de sobremesa o portátil fabricado en la última década. Se pueden instalar en un sistema existente sin necesidad de adaptadores especiales ni modificaciones en la BIOS. Su formato de 2,5 pulgadas se asemeja a una delgada caja rectangular de aproximadamente 100 mm x 70 mm, con un grosor de tan solo 7 mm. Este tamaño se adapta a las bahías de unidades estándar que se encuentran en la mayoría de las cajas de ordenadores de sobremesa.El rendimiento máximo de SATA III se sitúa teóricamente en 600 MB/s, aunque en la práctica alcanza aproximadamente los 550 MB/s de lectura y los 520 MB/s de escritura. Estas cifras representan una mejora considerable respecto a las unidades mecánicas. Sin embargo, la propia interfaz SATA crea un cuello de botella. El protocolo se diseñó originalmente para discos giratorios, no para memoria flash. Esta limitación explica por qué las soluciones de almacenamiento SSD SATA ofrecen mejoras de rendimiento consistentes, pero modestas, en comparación con las alternativas más recientes.Unidades SSD NVMe: Maximizando la velocidad con PCIeNVMe (Non-Volatile Memory Express) elimina por completo el cuello de botella de SATA. En lugar de enrutar los datos a través de un controlador SATA, NVMe se comunica directamente con la CPU del sistema mediante el bus PCIe. Esta diferencia arquitectónica reduce la latencia de los comandos de aproximadamente 6 microsegundos con AHCI a tan solo 2,8 microsegundos con NVMe. El protocolo se diseñó específicamente para memoria flash, lo que permite rutas de datos paralelas que maximizan el rendimiento.El diseño físico también difiere drásticamente. Las unidades M.2 NVMe se asemejan a pequeñas memorias USB en lugar de cajas, con un ancho de 22 mm y una longitud típica de 80 mm, y un grosor de tan solo 2 mm. Este formato compacto pesa entre 5 y 10 gramos, en comparación con los 40-60 gramos de una unidad SATA de 2,5 pulgadas. Los portátiles se benefician enormemente de esta optimización del espacio, lo que permite a los fabricantes crear dispositivos más delgados sin sacrificar la capacidad de almacenamiento SSD.Las cifras de rendimiento ilustran claramente la diferencia entre las interfaces. NVMe sobre PCIe 4.0 alcanza velocidades teóricas de hasta 8000 MB/s, con lecturas reales de entre 7000 y 7400 MB/s. Esto se traduce en aproximadamente diez veces la velocidad de SATA III. La última generación de PCIe 5.0 duplica el límite teórico a aproximadamente 16 000 MB/s, lo que permite gestionar cargas de trabajo exigentes como el análisis de IA y la computación de alto rendimiento. Los jugadores que utilicen una NVIDIA GeForce RTX 5090 notarán una carga de niveles y una transmisión de texturas más rápidas con una unidad NVMe. Los centros de datos que implementan soluciones SSD NVMe empresariales, como la Solidigm D7-P5520, dependen de esta velocidad para aplicaciones de misión crítica.La elección del tipo de SSD depende de las ranuras disponibles en la placa base y de los requisitos de rendimiento. Las unidades SATA ofrecen compatibilidad universal a un menor coste. Las unidades NVMe brindan una velocidad inigualable para quienes exigen la máxima capacidad de respuesta.SSD vs. disco duro: ¿Cuál es mejor?Al comparar una unidad de estado sólido (SSD) con un disco duro tradicional, las diferencias se hacen evidentes. La principal distinción radica en su diseño mecánico. Un disco duro convencional utiliza platos giratorios y un cabezal de lectura/escritura móvil. Las unidades de estado sólido, en cambio, emplean chips de memoria flash sin partes móviles. Esta diferencia fundamental determina todos los demás puntos de comparación.Velocidad, durabilidad y ruido: las principales diferenciasVelocidad La ventaja más notable de las unidades de estado sólido es su velocidad. Al no tener un disco giratorio, el sistema accede a los datos casi al instante. El tiempo de arranque se reduce de más de un minuto a solo segundos. Las aplicaciones se inician sin demora. Esta velocidad transforma la experiencia informática diaria. La comparación entre SSD y HDD demuestra que las SSD eliminan la latencia mecánica inherente a las unidades antiguas.Durabilidad También favorece el diseño de estado sólido. Debido a que no existen partes móviles, las SSD resisten los golpes físicos mucho mejor que los HDD. Los datos de confiabilidad de los controladores de discos duros de las SSD muestran que las SSD experimentan tasas de falla más bajas. Backblaze evaluó 284,386 unidades en el segundo trimestre de 2024. Encontraron una tasa de falla promedio anual del 1.71% para los discos duros. Un estudio de Schroeder & Gibson informó una tasa de reemplazo anual ponderada general del 3.01% para los HDD. El rango de tasas de falla abarcó desde el 0.5% hasta el 13.5% dependiendo de la antigüedad de la unidad. Las hojas de datos del fabricante enumeran la AFR típica para unidades de estado sólido del 0.58% al 0.88%. Las unidades flash experimentan tasas de reemplazo significativamente más bajas que los discos duros tradicionales, aunque pueden presentar tasas más altas de errores no corregibles. Las soluciones de almacenamiento SSD ofrecen una mayor confiabilidad para sus datos a largo plazo.Ruido Esta es otra área donde las unidades SSD sobresalen. Una unidad SSD produce cero decibelios en todas las condiciones de funcionamiento. Un disco duro genera ruido debido a sus platos giratorios y al cabezal de lectura/escritura.Tipo de almacenamientoNivel de ruido (dB)Condiciones de funcionamientoDisco duro (empresarial, SAS de 600 GB)30–35Funcionamiento normalDisco duro (empresarial, SAS de 600 GB)40–45Carga pesadaSSD (modelos SATA/SAS)0 (silencioso)Todas las condicionesEste silencio contribuye a un entorno informático más agradable.Ventajas y desventajas de hacer el cambioLas ventajas de las unidades de estado sólido (SSD) son innegables. Ofrecen tiempos de arranque más rápidos, funcionamiento más silencioso, mayor durabilidad y menor consumo de energía. La ausencia de piezas móviles reduce la generación de calor, lo que beneficia a los portátiles. La eficiencia energética es otra ventaja. Las SSD consumen menos energía que los discos duros (HDD), lo que prolonga la duración de la batería en los portátiles. Esta combinación de ventajas convierte a las unidades de estado sólido en la opción preferida para los ordenadores modernos. Para aplicaciones exigentes, como los videojuegos con una tarjeta gráfica de gama alta como la NVIDIA GeForce RTX 5090, una SSD garantiza una carga rápida de las texturas. Los usuarios empresariales se benefician de soluciones SSD NVMe empresariales como la Solidigm D7-P5520, que ofrecen un rendimiento constante para cargas de trabajo con gran cantidad de datos.El principal inconveniente sigue siendo el precio. La comparación de precios entre discos duros y SSD revela que los SSD aún cuestan más por gigabyte que los discos duros tradicionales. La siguiente tabla muestra los precios actuales.CapacidadCosto de SSD NVMePrecio de SSD de 2,5"Costo del disco duro1 TB$38.99$34.99$26.992 TB$69.98$68.98$35.994 TB$199.99$179.99$49.648 TB$899.99$499.00$99.9916 TB-$2499.99$224.99La diferencia de precio entre las unidades SSD y los discos duros tradicionales se ha reducido con el paso de los años, pero aún existe una brecha. Con una capacidad de 4 TB, una unidad SSD cuesta aproximadamente cuatro veces más que un disco duro tradicional. Otro factor importante es la vida útil. La mayoría de las unidades SSD modernas duran entre 5 y 10 años con un uso diario normal, superando a menudo el período de garantía habitual. La resistencia a la escritura es crucial para los usuarios intensivos. Las unidades SSD modernas gestionan esto mediante la nivelación de desgaste, lo que garantiza una larga vida útil. Para su almacenamiento SSD principal, esta longevidad justifica la inversión.Para la mayoría de los usuarios, las ventajas de las unidades de estado sólido (SSD) compensan su precio más elevado. La mejora en el rendimiento por sí sola justifica la inversión. La elección entre un disco duro tradicional y una SSD depende, en última instancia, de tu presupuesto y necesidades de almacenamiento. Si necesitas velocidad y capacidad, combina una SSD con discos duros tradicionales para un almacenamiento masivo. La versatilidad de una SSD la hace adecuada tanto para el uso diario como para cargas de trabajo profesionales.Guía práctica: Actualización a una unidad de estado sólido (SSD)Cómo elegir el SSD adecuado para tus necesidadesEl uso principal que le des a tu equipo determinará qué unidad de estado sólido se adapta mejor a tu flujo de trabajo. Los jugadores que combinan su sistema con una GPU de gama alta como la NVIDIA GeForce RTX 5090 necesitan una unidad NVMe con velocidades de lectura aleatoria rápidas. Los creadores de contenido se enfrentan a necesidades diferentes. Necesitan unidades separadas para su sistema, proyectos activos y archivos de caché en configuraciones avanzadas. Una configuración con una sola unidad obliga a hacer concesiones que ralentizan el proceso de edición.FactorConsideración claveGuía prácticaTipo de accionamientoLas unidades del sistema priorizan la baja latencia; las unidades de proyecto necesitan velocidades sostenidas y DRAM.Utilice unidades SSD separadas para el sistema, el proyecto y la caché en configuraciones avanzadas.Capacidad y TBWUna mayor capacidad se traduce en un mejor costo por TB y una mayor calificación total de TBW.Para obtener la mejor relación calidad-precio, elija discos duros de al menos 1 TB a 2 TB; los discos de mayor capacidad duran más con un uso intensivo de escritura.Caché DRAMLas unidades equipadas con DRAM evitan ralentizaciones durante escrituras prolongadas.Se recomienda utilizar DRAM para las unidades de proyecto; para las unidades de caché pueden ser suficientes las opciones que no utilizan DRAM.Velocidad en el mundo realLas velocidades secuenciales anunciadas rara vez se mantienen; la lectura/escritura aleatoria es más importante.Comprueba pruebas de rendimiento como PCMark 10; espera transferencias reales de alrededor de 2500–3000 MB/s.Los editores individuales que gestionan proyectos pequeños necesitan una solución de almacenamiento SSD de al menos 1 TB. Los equipos pequeños que colaboran de forma eficiente se benefician de un NAS centralizado con una capacidad de 4 TB a 8 TB. Los equipos más grandes que trabajan con vídeo de alta definición requieren almacenamiento compartido de 20 TB o más. Los estudios profesionales que producen contenido 4K/8K deberían invertir en una configuración SAN superior a 50 TB para un rendimiento óptimo y un mayor crecimiento futuro. La resolución del proyecto, el número de usuarios simultáneos y las necesidades de copia de seguridad son factores que influyen en esta decisión.Las cargas de trabajo empresariales requieren consideraciones diferentes. Una unidad SSD NVMe empresarial como la Solidigm D7-P5520 ofrece un rendimiento de almacenamiento SSD constante para centros de datos que ejecutan análisis de IA o aplicaciones de bases de datos. Estas unidades ofrecen una mayor durabilidad y funciones de protección contra pérdida de energía que los modelos para consumidores no tienen.Instalación y durabilidad: consejos para una conducción saludableAl actualizar desde un disco duro, tienes dos opciones de instalación. La clonación copia todo el sistema operativo y los archivos a la nueva unidad SSD. La instalación limpia te ofrece un lienzo en blanco, eliminando el desorden digital acumulado. La mayoría de los usuarios prefieren la clonación por comodidad, pero una instalación limpia suele ofrecer un mejor rendimiento de la unidad SSD a largo plazo.El comando TRIM desempeña un papel fundamental en el buen funcionamiento de su unidad. Esta instrucción del sistema operativo le indica a su SSD qué bloques de datos ya no son necesarios tras la eliminación de archivos. Su unidad borra proactivamente esos bloques y los prepara para futuras escrituras. Este proceso reduce la amplificación de escritura y los ciclos de borrado innecesarios. Al minimizar el movimiento interno de datos, TRIM disminuye el desgaste de las celdas de memoria flash y prolonga la vida útil de su unidad.También debes actualizar el firmware de tu unidad periódicamente usando las herramientas del fabricante. Habilita TRIM en la configuración de tu sistema operativo para garantizar el mantenimiento automático. Evita quitar la etiqueta de tu unidad, ya que esto puede anular la garantía. Realiza pruebas de rendimiento periódicamente para verificar que tu almacenamiento SSD mantenga los niveles de velocidad esperados. Estas sencillas prácticas mantendrán tu unidad de estado sólido funcionando correctamente durante años. Las mejoras en el tiempo de arranque y la mayor velocidad de carga de aplicaciones que experimentarás después de la instalación transformarán tu rutina informática diaria.El diseño de estado sólido transforma tu experiencia informática. La ausencia de piezas móviles se traduce en arranques más rápidos, un funcionamiento más silencioso y una mayor durabilidad. Tu SSD ofrece acceso instantáneo a los datos, tanto si juegas con una NVIDIA GeForce RTX 5090 como si gestionas cargas de trabajo empresariales con una SSD NVMe Solidigm D7-P5520.En 2026, el almacenamiento de estado sólido será estándar, no opcional. El mercado refleja este cambio. Los ingresos por SSD empresariales crecen de forma constante, pasando de 8.500 millones de dólares en 2024 a 21.500 millones de dólares en 2033, lo que representa una tasa de crecimiento anual compuesta del 12,3 %. Esta categoría de almacenamiento informático domina actualmente el desarrollo de nuevos sistemas.La tecnología de almacenamiento sigue evolucionando. Cada año aparecen interfaces más rápidas y memorias de mayor capacidad. Si aún utilizas un disco duro mecánico, actualízalo ahora. En el futuro, agradecerás la diferencia.Preguntas frecuentes¿Cuánto dura realmente un SSD?Las unidades de estado sólido modernas tienen una vida útil de 5 a 10 años con un uso diario normal. La nivelación de desgaste distribuye los ciclos de escritura de manera uniforme entre todas las celdas. Esta tecnología evita que cualquier área se desgaste prematuramente. La mayoría de las unidades superan el período de garantía sin problemas.¿Puedo instalar un SSD en mi ordenador antiguo?Sí, puedes actualizar prácticamente cualquier ordenador de sobremesa o portátil de la última década. Las unidades SSD SATA utilizan la misma interfaz que los discos duros tradicionales. Tu sistema reconocerá la unidad sin necesidad de adaptadores especiales ni cambios en la BIOS. Esta compatibilidad convierte a las unidades SSD en la opción de mejora de rendimiento más sencilla disponible.¿Mejorará mi experiencia de juego con un SSD??Por supuesto. Los juegos cargan los niveles más rápido y las texturas se reproducen sin interrupciones. Combinar una unidad SSD con una tarjeta gráfica potente como la NVIDIA GeForce RTX 5090 elimina los problemas de almacenamiento. Notarás pantallas de carga más cortas y una exploración de mundo abierto más fluida.¿Qué diferencia a las unidades SSD NVMe empresariales de los modelos para consumidores?Las unidades empresariales como la Solidigm D7-P5520 ofrecen mayor durabilidad y protección contra cortes de energía. Mantienen un rendimiento constante incluso bajo cargas de trabajo intensas y continuas. Las unidades para consumidores priorizan la rentabilidad para las tareas cotidianas. Los centros de datos requieren la fiabilidad que ofrecen las soluciones SSD NVMe empresariales.
  • NVIDIA SN5600 o Cisco 800GbE: Una comparación exhaustiva para centros de datos modernos
    NVIDIA SN5600 o Cisco 800GbE: Una comparación exhaustiva para centros de datos modernos
    August 27, 2026
    Elegir entre el NVIDIA Spectrum-4 SN5600 El Cisco Nexus G200 define toda su estrategia de red de IA. Necesita un switch que gestione un tráfico masivo de GPU sin cuellos de botella. La plataforma NVIDIA se integra profundamente con Spectrum-X y BlueField-3, creando una estructura altamente integrada para la computación acelerada. Cisco responde con flexibilidad multivendedor y cumplimiento UEC, lo que resulta atractivo para entornos heterogéneos. El futuro de su centro de datos depende de esta decisión. La arquitectura NVIDIA destaca por su Ethernet sin pérdidas y su enrutamiento adaptativo, minimizando la latencia de cola para el entrenamiento distribuido. La fortaleza de Cisco reside en la interoperabilidad basada en estándares, que permite combinar equipos de diferentes proveedores. Debe sopesar la dependencia de un ecosistema frente a la libertad operativa.Ten en cuenta la escala de tus cargas de trabajo de IA y tu tolerancia a las optimizaciones específicas del proveedor. Esta comparación te ayudará a evaluar ambas plataformas según tus requisitos específicos. Conclusiones claveElija NVIDIA SN5600 para una integración perfecta con el ecosistema de IA, incluyendo DGX y BlueField-3, que ofrece un rendimiento y una automatización superiores.Elija Cisco Nexus G200 para obtener flexibilidad de múltiples proveedores y cumplimiento con UEC, ideal para entornos heterogéneos y regulados.Ambos conmutadores ofrecen un rendimiento de 51,2 Tbps, pero NVIDIA destaca en Ethernet sin pérdidas y enrutamiento adaptativo, mientras que Cisco ofrece ingeniería de tráfico granular.Evalúe la magnitud de su carga de trabajo, su compromiso con el ecosistema y sus necesidades de cumplimiento normativo para alinear su elección con los objetivos de infraestructura a largo plazo.Realice una prueba de concepto con sus cargas de trabajo reales para validar el rendimiento y la idoneidad operativa antes de comprometerse. Descripción general de la plataforma: SN5600 frente a Cisco Nexus G200Antes de evaluar las métricas de rendimiento, es necesario comprender qué impulsa cada plataforma. El NVIDIA Spectrum-4 SN5600 y el Cisco Nexus G200 representan dos filosofías distintas para redes 800GbE. La elección entre ellas determinará toda su estrategia de infraestructura de IA.Dentro del NVIDIA Spectrum-4 SN5600: ASIC y búferEl NVIDIA Spectrum-4 SN5600 se basa en un ASIC diseñado específicamente para ofrecer un rendimiento excepcional en cargas de trabajo de IA. Este conmutador proporciona un ancho de banda bidireccional de 51,2 Tbps, lo que garantiza un alto rendimiento con baja latencia. Este rendimiento se logra gracias a un ingenioso diseño SerDes.El ASIC Spectrum-4 utiliza carriles SerDes de 100 Gb/s, que se consiguen mediante señalización nativa de 50 Gb/s con codificación PAM-4 (2 bits por señal).Estos carriles se agrupan en conjuntos de 8 para formar un único puerto 800 GbE.Con 64 puertos de este tipo, el rendimiento agregado se calcula como: 64 puertos × 800 Gb/s = 51,2 Tb/s.Esta configuración está dirigida específicamente a las interconexiones de centros de datos regionales, donde los puertos 800 GbE son el elemento clave.Más allá de su velocidad bruta, el SN5600 cuenta con una arquitectura de búfer de paquetes dinámico totalmente compartido. Este diseño absorbe eficazmente las microrráfagas, manteniendo una baja latencia predecible durante el entrenamiento distribuido. Además, ofrece compatibilidad nativa con RoCE y optimización para Ethernet NVIDIA Spectrum-X, creando una estructura altamente integrada para clústeres de GPU. El conmutador procesa hasta 33.300 millones de paquetes por segundo, lo que garantiza la ausencia de pérdida de paquetes bajo carga sostenida. Cisco Nexus G200: Preparación para Silicon One y UECEl Cisco Nexus G200 adopta un enfoque diferente con su ASIC Silicon One G200. Este switch prioriza la interoperabilidad con múltiples proveedores y el cumplimiento de estándares. Disfrutará de configuraciones de puertos flexibles que se adaptan a diversos entornos de red.EspecificaciónValorRendimiento51,2 Tbps (dúplex completo)Configuración del puertoDe 64x800GE a 512x100GECisco prepara esta plataforma para UEC, lo que permite integrarla en redes heterogéneas sin depender de un software propietario. La arquitectura Silicon One admite ingeniería de tráfico avanzada, brindando un control preciso sobre los flujos de datos. Para entornos con altos requisitos de cumplimiento normativo, la línea Cisco Nexus ofrece la gestión familiar de NX-OS, reduciendo la carga operativa. Tu decisión dependerá de las prioridades del ecosistema. La plataforma NVIDIA destaca cuando te comprometes con la integración de NVIDIA Spectrum-X Ethernet y BlueField-3. Cisco resulta atractiva cuando necesitas flexibilidad con múltiples proveedores. Ambos switches ofrecen 51,2 Tbps, pero sus puntos fuertes difieren en cómo gestionan la optimización de la estructura de IA frente a la adaptabilidad basada en estándares. Comparación de especificaciones lado a ladoPara evaluar estas plataformas, necesita datos concretos. Ambos conmutadores ofrecen un rendimiento full-duplex de 51,2 Tbps, pero sus arquitecturas difieren significativamente. La siguiente tabla resume las especificaciones esenciales que debe tener en cuenta.EspecificaciónNVIDIA Spectrum-4 SN5600Cisco Nexus G200ASICEspectro-4Silicon One G200Rendimiento51,2 Tbps51,2 TbpsDensidad portuariaDe 64x800 GbE a 512x100 GbEDe 64x800GE a 512x100GEProcesamiento de paquetes33,3 BppsVelocidad de línea comparableArquitectura de búferBúfer de paquetes dinámico totalmente compartidoBúfer compartido configurableSistema operativo de gestiónSistema operativo Cumulus Linux / NVIDIANX-OS Estadísticas de rendimiento: velocidad de línea, puertos y latencia.El NVIDIA Spectrum-4 SN5600 alcanza una velocidad de línea real de 800G en sus 64 puertos simultáneamente. Este rendimiento se logra mediante carriles SerDes de 100 Gb/s con codificación PAM-4. Cada puerto agrupa ocho carriles para formar una única conexión 800GbE. Esta configuración está diseñada para interconexiones de centros de datos regionales, donde los puertos 800GbE de alta densidad eliminan los cuellos de botella. El Cisco Silicon One G200 ofrece un rendimiento similar con la misma densidad de puertos. Puede configurar el switch de forma flexible, desde 64 puertos a 800GE hasta 512 puertos a 100GE. Esta flexibilidad se adapta a diversas topologías de red. Ambas plataformas procesan paquetes a velocidad de línea sin perder tramas bajo carga sostenida. La latencia distingue a estos conmutadores de forma sutil. La plataforma NVIDIA mantiene una latencia baja y predecible gracias a su diseño de búfer dinámico. Experimentará un reenvío de paquetes constante incluso durante eventos de microráfaga. Cisco logra cifras de latencia comparables con su arquitectura Silicon One, aunque la estrategia de gestión del búfer difiere. Su carga de trabajo determinará qué enfoque le conviene más. Control de congestión y enrutamiento adaptativoLas cargas de trabajo de IA generan patrones de tráfico únicos que saturan los mecanismos tradicionales de control de congestión. Se requiere una gestión inteligente de la infraestructura para mantener el rendimiento durante el entrenamiento distribuido. Ambos proveedores abordan este desafío de manera diferente.NVIDIA implementa el enrutamiento adaptativo directamente en el ASIC Spectrum-4. Esta función redirige dinámicamente el tráfico para evitar rutas congestionadas sin intervención de la CPU. Se beneficia de la selección automática de rutas que responde a las condiciones de la red en tiempo real. El switch combina esta capacidad con la compatibilidad nativa con RoCEv2, lo que permite Ethernet sin pérdidas para el tráfico RDMA. El enfoque de NVIDIA minimiza la latencia de cola al prevenir la formación de puntos críticos. Cisco se basa en mecanismos de control de congestión estándar, principalmente DCQCN (Notificación Cuantificada de Congestión para Centros de Datos). Se configuran umbrales de notificación de congestión explícitos para gestionar la ocupación del búfer. El ASIC Silicon One admite ingeniería de tráfico avanzada, lo que permite un control preciso de la ubicación del flujo. Este enfoque basado en estándares garantiza la interoperabilidad con conmutadores de terceros en su red. La experiencia de gestión difiere sustancialmente entre plataformas. NVIDIA ofrece Cumulus Linux, que proporciona un entorno operativo Linux familiar. La automatización del switch se realiza mediante herramientas DevOps estándar. Cisco NX-OS ofrece la interfaz de línea de comandos que los ingenieros de red ya conocen. La familiaridad operativa de su equipo debe influir en su elección. Para la optimización de la infraestructura de IA, el enrutamiento adaptativo de NVIDIA ofrece una clara ventaja. El conmutador equilibra automáticamente el tráfico entre las rutas disponibles, reduciendo la pérdida de paquetes por congestión. El enfoque de Cisco requiere una configuración más manual, pero ofrece un mayor control para entornos especializados. Debe evaluar si la automatización o el control granular se ajustan mejor a su modelo operativo. La arquitectura del búfer representa otra distinción crucial. El búfer dinámico totalmente compartido de NVIDIA absorbe eficazmente las microráfagas, manteniendo un rendimiento constante durante el tráfico de IA en ráfagas. El búfer configurable de Cisco permite asignar recursos en función del perfil de tráfico específico. Ambos enfoques evitan la pérdida de paquetes, pero lo logran mediante mecanismos diferentes. En última instancia, la elección depende de la complejidad de la infraestructura y de la experiencia del equipo. La plataforma NVIDIA destaca en entornos de IA altamente integrados donde la automatización es fundamental. La flexibilidad de Cisco resulta ideal para redes heterogéneas que requieren optimización manual. Características de rendimiento e IA de Fabric Optimizaciones de Ethernet sin pérdidas y RDMASu clúster de IA requiere Ethernet sin pérdidas para proteger el tráfico RDMA de la pérdida de paquetes. El NVIDIA SN5600 ofrece compatibilidad nativa con RoCEv2 con un búfer de paquetes dinámico totalmente compartido. Esta arquitectura absorbe las microrráfagas a nivel del conmutador, evitando que la congestión se propague por su red. Mantiene una latencia predecible incluso cuando múltiples GPU Los nodos fallan simultáneamente durante los puntos de control del entrenamiento. Cisco logra una transmisión sin pérdidas mediante protocolos Data Center Bridging. El control de flujo prioritario (PFC) envía tramas de pausa para gestionar los flujos Ethernet, mientras que la notificación explícita de congestión (ECN) marca los paquetes que experimentan congestión sin descartarlos. Este enfoque basado en estándares es compatible con conmutadores de terceros en su red. Usted configura estos mecanismos a través de NX-OS, ajustando los umbrales para que coincidan con su perfil de carga de trabajo. La plataforma NVIDIA minimiza la latencia de cola mediante la asignación dinámica de búfer. Cuando un puerto experimenta una ráfaga de tráfico, el conmutador redistribuye automáticamente la capacidad del búfer desde los puertos inactivos. De esta forma, las tareas de entrenamiento distribuidas evitan el efecto de retardo que ralentiza el tiempo total de iteración. El búfer configurable de Cisco requiere ajuste manual, pero ofrece un control preciso para patrones de tráfico especializados. Ingeniería de tráfico para cargas de trabajo de IALa tecnología Ethernet de NVIDIA Spectrum-X integra el enrutamiento adaptativo directamente en el ASIC. El conmutador redirige el tráfico evitando rutas congestionadas sin intervención de la CPU, adaptándose a las condiciones de la red en tiempo real. Se beneficia de la selección automática de rutas, que previene la formación de puntos críticos. Esta capacidad resulta esencial para la red de backend de IA, donde los patrones de tráfico varían de forma impredecible a través de miles de conexiones de GPU. Cisco responde con Intelligent Packet Flow, una completa suite de ingeniería de tráfico. El Silicon One G200 admite balanceo de carga dinámico (basado en flowlet) que distribuye el tráfico según la telemetría de utilización del enlace. También se obtiene balanceo de carga por paquete, que distribuye los paquetes a través de múltiples rutas para maximizar el rendimiento. Weighted Cost Multipath (WCMP) permite la ponderación inteligente de rutas para topologías asimétricas. El balanceo de carga basado en políticas asigna estrategias específicas a cargas de trabajo mixtas según ACL, marcas DHCP o encabezados RoCEv2. La visibilidad diferencia estas plataformas para el análisis de cargas de trabajo de IA. Cisco proporciona telemetría de flujo de hardware que registra cada paquete que atraviesa el conmutador, incluyendo microráfagas y pérdidas. Los contadores de marcas ECN informan sobre la congestión por dispositivo, por interfaz y a nivel de flujo a través de Nexus Dashboard Insights. Las estadísticas de paquetes PFC revelan los marcos de pausa emitidos por clase de servicio, lo que permite el ajuste de la congestión en tiempo real. NVIDIA utiliza la telemetría integrada de Spectrum-4, lo que proporciona visibilidad de toda la estructura a través del plano de administración de Spectrum-X. Su infraestructura de backend de IA se beneficia de ambos enfoques. El enrutamiento adaptativo de NVIDIA reduce la intervención manual, ideal para el entrenamiento de IA a gran escala donde la automatización es fundamental. Los controles basados ​​en políticas de Cisco son adecuados para entornos heterogéneos que requieren una gestión precisa del tráfico. El switch que elija determinará el grado de control que ejerce sobre los flujos de datos de su clúster de IA. Escenarios de casos de uso: cuándo elegir cada unoLas características de tu carga de trabajo determinan qué plataforma te conviene más. La NVIDIA SN5600 destaca en entornos de IA altamente integrados, mientras que la Cisco Nexus G200 se desenvuelve mejor en redes heterogéneas y sujetas a normativas. Comprender estos escenarios te ayuda a alinear tu inversión en infraestructura con tu realidad operativa. NVIDIA SN5600 para un ecosistema NVIDIA compacto (DGX, BlueField)Cuando los nodos de computación, el almacenamiento y la red forman una pila unificada, se opera una infraestructura de IA centrada en NVIDIA. El switch NVIDIA Spectrum-4 SN5600 se integra a la perfección con las arquitecturas DGX SuperPOD, proporcionando el ancho de banda que requieren los clústeres de GPU. NVIDIA diseña este switch específicamente para las redes Ethernet Spectrum-X, creando un entorno cohesionado donde cada componente se comunica de forma óptima. La arquitectura de referencia DGX SuperPOD demuestra claramente esta integración. Puede escalar su entorno de entrenamiento de IA desde 2304 GPU hasta 9216 GPU en 16 unidades escalables (SU). Cada SU combina dos conmutadores SN5600 como capa central, agregando conmutadores de acceso que se conectan a las bandejas de computación y almacenamiento DGX. Para implementaciones de mayor tamaño, puede agregar una capa central superior con dos grupos, manteniendo características sin bloqueo en toda la red.Escala (GPU)Escala (SU)Grupos de Super Columna VertebralSuperespinas por grupoInterruptores de columna vertebral súper completosCambios totales de columna vertebral2304422464460882481289216162714256921616624144512 La integración de la DPU BlueField-3 optimiza aún más el rendimiento de su clúster de IA. La versión DOCA 2.7 habilita la arquitectura de referencia Spectrum-X 1.0.1, probada específicamente para las tarjetas BlueField SuperNIC combinadas con conmutadores SN5600. Esta arquitectura ofrece Ethernet sin pérdidas mediante enrutamiento adaptativo y control de congestión programable DOCA. Se logra GPUDirect RDMA con las tarjetas BlueField SuperNIC que se envían en modo NIC por defecto, lo que simplifica la implementación. Los resultados de las pruebas de rendimiento demuestran el impacto tangible. Una carga de trabajo de ajuste fino se completa en 1 hora y 40 minutos con GPUDirect RDMA usando SN5600 y BlueField-3. La misma carga de trabajo tarda 2 horas y 30 minutos con TCP/Socket sobre Ethernet Spectrum-4, y 5 horas con una red OVN predeterminada. Obtendrá una mejora de 3 veces con respecto a la configuración base, lo que acelera directamente sus ciclos de entrenamiento de IA. Cisco Nexus G200 para entornos multivendedor y FedRAMPEl Cisco Nexus G200 es la opción ideal cuando su centro de datos abarca equipos de múltiples proveedores y los requisitos de cumplimiento normativo son prioritarios en su toma de decisiones. Este switch es compatible con los estándares UEC, lo que le permite integrar equipos de diversos fabricantes sin restricciones de propiedad. Su red se mantiene abierta y adaptable a medida que evolucionan los estándares. La plataforma Cisco Nexus destaca en entornos donde no es posible comprometerse con un único ecosistema. Permite combinar switches de diferentes proveedores, manteniendo la flexibilidad operativa en toda la infraestructura. La gestión mediante NX-OS proporciona herramientas familiares para el equipo de ingeniería de red, lo que reduce los costos de capacitación y el riesgo operativo. El cumplimiento de FedRAMP representa un factor diferenciador crucial para el gobierno y las industrias reguladas. El marco de cumplimiento establecido por Cisco simplifica su proceso de certificación. Usted implementa el G200 en entornos que requieren estrictos controles de seguridad, con la certeza de que la plataforma cumple con rigurosos estándares federales. Esta capacidad resulta esencial para contratos del sector público y cargas de trabajo comerciales reguladas. Su infraestructura de backend de IA se beneficia de la ingeniería de tráfico basada en políticas de Cisco. Configure estrategias de balanceo de carga que se adapten a sus patrones de carga de trabajo específicos, ya sea que ejecute entrenamiento distribuido o inferencia a gran escala. El ASIC Silicon One G200 proporciona un control granular sobre los flujos de datos, lo que permite una gestión precisa de los recursos de su clúster de IA. La decisión final depende de su estrategia de ecosistema. Elija NVIDIA Cuando se compromete con una plataforma de IA totalmente integrada con componentes de DGX y BlueField, elija Cisco si necesita flexibilidad multivendedor, cumplimiento con UEC y credenciales regulatorias consolidadas. La arquitectura de su infraestructura de back-end de IA debe reflejar la visión de infraestructura a largo plazo de su organización. Marco de decisión y lista de verificaciónCriterios clave de selección: escala, ecosistema y estándares.La evaluación comienza con la escala de la carga de trabajo. La NVIDIA SN5600 destaca al operar entornos de entrenamiento de IA a gran escala con miles de GPU. La Cisco Nexus G200 es ideal para redes heterogéneas donde la interoperabilidad entre múltiples proveedores es más importante que la integración estricta. Es fundamental evaluar con objetividad la trayectoria de crecimiento de su clúster de IA antes de decidirse por cualquiera de las dos plataformas. El compromiso con el ecosistema influye significativamente en su decisión. La plataforma Nvidia ofrece el máximo valor al combinarla con sistemas DGX y DPU BlueField-3. Esta integración crea una estructura de IA cohesiva con optimización automatizada. La alternativa Cisco Nexus proporciona libertad operativa, permitiéndole combinar switches de diferentes fabricantes sin restricciones de propiedad. Su tolerancia a la dependencia de un proveedor específico determinará qué enfoque se ajusta mejor a su estrategia de infraestructura. La preparación para los estándares influye en la viabilidad a largo plazo. Cisco posiciona el G200 para el cumplimiento de UEC, preparando su red para el futuro a medida que evolucionan los estándares de la industria. NVIDIA se centra en la optimización de Spectrum-X, ofreciendo un rendimiento superior hoy mismo mediante mejoras propias. Debe sopesar los beneficios inmediatos del análisis de cargas de trabajo de IA frente a los requisitos de interoperabilidad futuros. Lista de verificación práctica para arquitectos de centros de datosRevise esta lista de verificación antes de seleccionar su plataforma de conmutador 800GbE:Documente sus principales tipos de carga de trabajo: entrenamiento distribuido, inferencia o tráfico empresarial mixto.Calcula el ancho de banda necesario por rack y la capacidad total de la estructura de red.Evalúe el grado de familiaridad operativa de su equipo con Cumulus Linux en comparación con NX-OS.Evalúe su tolerancia a las optimizaciones específicas de cada proveedor frente a los estándares abiertos.Verifique los requisitos de cumplimiento, incluido FedRAMP para contratos gubernamentales.Proyecte el crecimiento de su clúster de IA durante los próximos tres a cinco años.Pruebe ambas plataformas en una prueba de concepto con sus patrones de carga de trabajo reales.Tu infraestructura preparada para IA depende de que las capacidades del switch se ajusten a la realidad operativa. La plataforma de Nvidia ofrece un rendimiento superior para entornos de IA dedicados. El switch de Cisco proporciona flexibilidad para diversos ecosistemas de centros de datos. Ejecuta pruebas de rendimiento controladas para medir el rendimiento, la latencia y el comportamiento de la congestión según tus perfiles de tráfico específicos. En definitiva, la decisión busca un equilibrio entre las necesidades de rendimiento inmediatas y la flexibilidad arquitectónica a largo plazo. La arquitectura de su centro de datos debe reflejar la dirección estratégica de su organización. Elija la plataforma que satisfaga las necesidades actuales de su clúster de IA y que, al mismo tiempo, permita el crecimiento futuro. La decisión sobre la arquitectura de IA depende de la estrategia de su ecosistema. La plataforma Nvidia destaca por su integración precisa en arquitecturas de IA con una gestión de búfer y RDMA nativa superior. Sus cargas de trabajo de IA se benefician de la asignación dinámica de búfer del ASIC Nvidia Spectrum-4. El switch Nvidia minimiza la latencia de cola para el entrenamiento distribuido. La alternativa Cisco Nexus ofrece mayor flexibilidad en entornos multivendedor. Su red permanece abierta gracias al cumplimiento de UEC integrado en el switch Cisco. Debe evaluar los requisitos de su centro de datos en función de las ventajas de cada plataforma. La infraestructura adecuada para IA depende de su escala, ecosistema y necesidades de cumplimiento. Evalúe las características de su carga de trabajo de IA y realice una prueba de concepto para validar su elección. Su arquitectura Nvidia ofrece un rendimiento máximo para clústeres de IA dedicados. Su red Cisco admite entornos heterogéneos con diversos flujos de datos. Para entornos centrados en Nvidia, esta arquitectura garantiza un rendimiento óptimo para su arquitectura de IA. Preguntas frecuentes¿Qué plataforma ofrece un mejor rendimiento para las cargas de trabajo de entrenamiento de IA?La NVIDIA SN5600 destaca en entornos de IA dedicados gracias a la optimización Spectrum-X y el enrutamiento adaptativo. Su búfer dinámico absorbe eficazmente las microráfagas, minimizando la latencia de cola durante el entrenamiento distribuido. Cisco ofrece un rendimiento comparable, pero requiere una mayor configuración manual para los patrones de tráfico específicos de la IA. La escala de su carga de trabajo determinará qué enfoque le conviene más.¿Puedo integrar cualquiera de los dos switches en una red multivendedor existente?El Cisco Nexus G200 ofrece una flexibilidad superior para entornos heterogéneos. Su compatibilidad con UEC y su control de congestión basado en estándares permiten una perfecta interoperabilidad con equipos de terceros. El switch NVIDIA se integra de forma óptima dentro de un ecosistema NVIDIA completo. Su tolerancia a la dependencia de un proveedor específico debe guiar esta decisión.¿Qué experiencia de gestión debo esperar de cada cambio?NVIDIA ofrece Cumulus Linux, un entorno operativo Linux familiar. La automatización del switch se realiza mediante herramientas DevOps estándar. Cisco ofrece NX-OS con la interfaz de línea de comandos que los ingenieros de red ya conocen. La familiaridad operativa del equipo con cualquiera de las dos plataformas reduce los costos de capacitación y el riesgo operativo.¿Cómo gestionan estos conmutadores el control de congestión de forma diferente?NVIDIA implementa el enrutamiento adaptativo directamente en el ASIC Spectrum-4, redirigiendo dinámicamente el tráfico para evitar rutas congestionadas sin intervención de la CPU. Cisco se basa en DCQCN y umbrales de notificación de congestión explícitos. Estos mecanismos se configuran a través de NX-OS, ajustando los parámetros para que coincidan con el perfil de carga de trabajo y la topología de la red.¿Qué interruptor ofrece un mejor soporte para la evolución futura de los estándares?Cisco posiciona el Nexus G200 para la compatibilidad con UEC, preparando su red para el futuro a medida que maduran los estándares de la industria. NVIDIA se centra en la optimización de Spectrum-X, ofreciendo un rendimiento superior hoy mismo mediante mejoras propias. Su visión de infraestructura a largo plazo determinará qué enfoque se alinea con la estrategia de arquitectura de su centro de datos.
  • Análisis del Seagate Exos X18 de 12 TB: especificaciones, rendimiento y casos de uso empresarial
    Análisis del Seagate Exos X18 de 12 TB: especificaciones, rendimiento y casos de uso empresarial
    August 23, 2026
    Análisis del Seagate Exos X18 de 12 TB: especificaciones, rendimiento y casos de uso empresarialSi está seleccionando un disco duro para un servidor, una matriz RAID, un centro de datos o un sistema de almacenamiento a gran escala, la capacidad por sí sola no debería ser el único factor determinante. También debe considerar la compatibilidad de la interfaz, el rendimiento sostenido, los requisitos de carga de trabajo, la tecnología de grabación, la fiabilidad y el funcionamiento del disco durante su vida útil.  El Seagate Exos X18 de 12 TB Está diseñado precisamente para este tipo de entorno. En este análisis, verá qué ofrece la unidad, cómo se comporta el modelo ST12000NM000J SATA sobre el papel, dónde encaja en una arquitectura de almacenamiento empresarial y cuándo conviene elegirlo en lugar de un disco duro para consumidores o para NAS. El Seagate Exos X18 12TB ST12000NM000J es un disco duro SATA empresarial de 3,5 pulgadas con una capacidad de 12 TB, una velocidad de rotación de 7200 RPM, 256 MB de caché, grabación CMR, sellado hermético con helio e interfaz SATA de 6 Gb/s. Está diseñado para cargas de trabajo de almacenamiento empresarial de alta capacidad, incluyendo servidores, sistemas RAID, almacenamiento en la nube y entornos de centros de datos. Seagate Exos X18 de 12 TB: Especificaciones claveAntes de decidir si este disco duro empresarial es adecuado para su sistema, primero debe verificar el número de modelo exacto.La página del producto AILINK100 incluye el ST12000NM000J, la versión SATA del Exos X18 de 12 TB. La documentación de Seagate también identifica el ST12000NM000J como un modelo estándar SATA de 6 Gb/s y 12 TB. EspecificaciónSeagate Exos X18 12TB ST12000NM000JSerie de productosSeagate Exos X18ModeloST12000NM000JCapacidad12 TBFactor de forma3,5 pulgadasInterfazSATA 6 Gb/sVelocidad del husillo7200 RPMCache256 MBTecnología de grabaciónRMCDiseño de accionamientoSellado con helioTasa de transferencia sostenidaHasta aproximadamente 270 MB/sCalificación de carga de trabajo anualHasta 550 TB/añoMTBFHasta 2,5 millones de horas Las cifras anteriores se basan en la información actual del producto AILINK100 y la documentación de Seagate Exos X18. Para una implementación real, siempre debe verificar el número de pieza exacto, el firmware, la interfaz, el formato del sector y la compatibilidad con el servidor antes de realizar un pedido al por mayor. ¿Para qué está diseñado el Seagate Exos X18 de 12 TB?El Exos X18 pertenece a la familia de discos duros empresariales de Seagate, en lugar de a sus productos de almacenamiento orientados al consumidor.Esa distinción es importante a la hora de construir infraestructuras.Un disco duro empresarial de 12 TB se suele elegir cuando se necesita una combinación de:Alta densidad de almacenamientoOperación continuaRendimiento sostenido y predecibleRAID o grandes matrices de almacenamientoCompatibilidad con servidores empresarialesAlta capacidad de carga de trabajo anualEconomía del despliegue a gran escala La documentación de Seagate identifica a la familia Exos X18 como unidades de almacenamiento para empresas y enumera características que incluyen construcción sellada con helio, grabación CMR, tecnología de ahorro de energía en reposo PowerChoice, tecnología de potencia/rendimiento PowerBalance y compatibilidad con conexión en caliente.Para usted, la conclusión principal es sencilla: el Exos X18 de 12 TB está diseñado para formar parte de una infraestructura de almacenamiento, no simplemente para ser un disco duro de escritorio de gran capacidad. Análisis del rendimiento del Seagate Exos X18 de 12 TB7200 RPM para un rendimiento constante de discos duros empresariales.El Exos X18 de 12 TB funciona a 7200 RPM.Eso no lo hace comparable a una SSD NVMe en cuanto a latencia o rendimiento de E/S aleatoria. No deberías comprar un disco duro empresarial esperando una capacidad de respuesta similar a la de una SSD. En cambio, la ventaja reside en su equilibrio entre:Gran capacidadRendimiento secuencialCapacidad de carga de trabajo empresarialCoste por terabyteOperación de larga duraciónPara cargas de trabajo dominadas por lecturas y escrituras secuenciales, almacenamiento masivo, copias de seguridad, repositorios de medios, lagos de datos y otras aplicaciones orientadas a la capacidad, este diseño tiene mucho más sentido que utilizar capacidad SSD premium por cada terabyte. Transferencia sostenida de hasta aproximadamente 270 MB/sLa documentación del SATA Exos X18 indica un rendimiento de transferencia sostenida de hasta aproximadamente 270 MB/s, dependiendo de la capacidad específica y las condiciones de funcionamiento.Al evaluar esta cifra, tenga en cuenta la carga de trabajo.Si su aplicación está dominada por:Transferencias de archivos secuencialesCopia de seguridad y restauracióngrandes conjuntos de datosCargas de trabajo de archivorepositorios de vídeoAlmacenamiento masivo de datosUn disco duro empresarial de alta capacidad puede ser una capa de almacenamiento eficaz.Si su carga de trabajo requiere una latencia extremadamente baja o un IOPS aleatorio muy alto, debería evaluar en su lugar las unidades SSD empresariales o el almacenamiento NVMe. Por qué es importante la gestión de la memoria caché (CMR) en el Exos X18 de 12 TB.Una de las especificaciones más importantes que hay que comprobar al comprar un disco duro para un sistema de almacenamiento empresarial es la tecnología de grabación.El Exos X18 utiliza grabación magnética convencional (CMR). La documentación del producto de Seagate especifica que la familia X18 utiliza CMR.¿Por qué es importante esto?Si está creando matrices RAID u otros sistemas de almacenamiento con uso intensivo de escritura, es fundamental un comportamiento de escritura predecible. Las unidades CMR suelen ser la opción preferida para cargas de trabajo donde un comportamiento de escritura sostenido y consistente es más importante que maximizar la densidad de almacenamiento mediante técnicas de grabación alternativas. Por este motivo, el Exos X18 de 12 TB puede ser una opción sensata a la hora de evaluar discos duros para:Almacenamiento RAIDServidores de archivos empresarialesSistemas de respaldoGrandes sistemas de almacenamientoNiveles de capacidad de los centros de datos ¿El Seagate Exos X18 de 12 TB es CMR o SMR?El Seagate Exos X18 de 12 TB ST12000NM000J es una unidad CMR, no una unidad SMR. La documentación oficial de Seagate para el Exos X18 indica que la grabación magnética convencional es una característica de esta familia de discos duros.Este es un punto importante que se debe verificar antes de implementar varios discos duros en un entorno RAID o de almacenamiento empresarial. Diseño sellado con helio: por qué es importanteEl Exos X18 utiliza un diseño de unidad sellada con helio.Seagate enumera la arquitectura sellada con helio como una de las características principales de la familia Exos X18.El objetivo práctico es reducir la resistencia que experimentan los platos y cabezales internos en comparación con un diseño lleno de aire, lo que contribuye a una mayor densidad de almacenamiento y eficiencia energética.Para una sola unidad, la diferencia puede no ser el factor principal de compra.Sin embargo, en un sistema de almacenamiento que contiene docenas o cientos de unidades, las pequeñas diferencias en potencia y densidad pueden llegar a ser mucho más significativas.Esta es una de las razones por las que el diseño de discos duros empresariales debe evaluarse a nivel de sistema, en lugar de fijarse únicamente en la capacidad y las RPM. Carga de trabajo y fiabilidad del disco duro Seagate Exos X18 de 12 TBLa especificación AILINK100 indica una carga de trabajo anual de hasta 550 TB/año y un tiempo medio entre fallos (MTBF) de 2,5 millones de horas para la configuración ST12000NM000J.Estas cifras son útiles para comparar discos duros empresariales, pero deben interpretarse correctamente.El valor de MTBF no predice que una unidad de control individual funcionará durante 2,5 millones de horas. Es una métrica estadística de fiabilidad utilizada en la evaluación de productos y flotas de vehículos.Asimismo, la carga de trabajo anual debe compararse con el tráfico de almacenamiento previsto.Por ejemplo, si su servidor realiza copias de seguridad frecuentes, grandes transferencias de datos, cargas de trabajo analíticas u otras operaciones de alto volumen, estimar la cantidad anual de datos escritos y leídos puede ayudarle a determinar si un disco duro empresarial es el adecuado. ¿Es el Seagate Exos X18 de 12 TB adecuado para servidores?Sí, siempre y cuando la interfaz, el formato del sector, el firmware y la compatibilidad física coincidan con los de su servidor o controlador de almacenamiento.El Exos X18 está diseñado para entornos empresariales, y Seagate ofrece variantes SATA y SAS dentro de la familia X18.Para el modelo específico ST12000NM000J, está viendo la versión SATA de 6 Gb/s.Antes de comprar, compruebe:¿Su placa base de servidor admite SATA de 6 Gb/s?¿El controlador RAID es compatible con la unidad?¿Es compatible con el formato de 3,5 pulgadas?¿Su servidor acepta la capacidad de la unidad?¿El formato de sector es compatible con su software de almacenamiento?¿El proveedor del servidor incluye esta unidad o un modelo equivalente en su lista de unidades compatibles?Esto es especialmente importante para las compras empresariales, ya que un disco duro físicamente compatible no es necesariamente un disco duro totalmente validado para todas las plataformas de servidores. ¿Es el Seagate Exos X18 de 12 TB adecuado para RAID?El Exos X18 está diseñado para entornos de almacenamiento empresarial y puede utilizarse como parte de arquitecturas de almacenamiento basadas en RAID cuando el controlador RAID, el servidor, el backplane y la configuración del firmware son compatibles con la unidad. AILINK100 posiciona específicamente el ST12000NM000J para sistemas RAID y cargas de trabajo de almacenamiento empresarial.Sin embargo, para una implementación RAID, conviene evaluar más que solo el disco duro.Considerar:Nivel RAIDNúmero de unidadesCompatibilidad del controladorEstrategia de reserva en calienteTiempo de reconstrucciónPolítica de copia de seguridadDiseño del dominio de fallosCarga de trabajo previstaCapacidad útil requeridaPor ejemplo, aumentar el número de discos duros de 12 TB puede proporcionar una capacidad bruta considerable, pero la configuración RAID determina cuánta de esa capacidad está realmente disponible para sus aplicaciones.En otras palabras, 12 TB por disco no significa 12 TB de almacenamiento utilizable por disco después de la configuración RAID. SATA vs SAS: Asegúrese de elegir el modelo Exos X18 correcto.Este es uno de los aspectos más importantes a tener en cuenta al comprar.La familia Exos X18 incluye diferentes interfaces y números de modelo.Para 12 TB, la documentación de Seagate indica lo siguiente:ST12000NM000J — SATA 6 Gb/sST12000NM004J — SAS 12 Gb/sTambién existen variantes SED y SED-FIPS con diferentes números de modelo.Por lo tanto, si su sistema de almacenamiento requiere SAS, no debería pedir automáticamente el SATA ST12000NM000J simplemente porque la capacidad sea la correcta.Del mismo modo, si su servidor está diseñado para usar SATA, debe verificar que el modelo SAS sea compatible antes de cambiar de interfaz. Comparación rápidaRequisitoST12000NM000JST12000NM004JCapacidad12 TB12 TBInterfazSATA 6 Gb/sSAS 12 Gb/sDespliegue típicoServidores/sistemas de almacenamiento SATASistemas de almacenamiento empresarial SAS¿El mismo modelo?NoNoReemplazo directoSolo cuando el sistema lo admitaSolo cuando el sistema lo admitaLa documentación oficial de Seagate debe ser su referencia final para las especificaciones a nivel de modelo. ¿Quién debería considerar el disco duro Seagate Exos X18 de 12 TB?Esta unidad es especialmente relevante cuando se necesita almacenamiento HDD de alta capacidad y la infraestructura es compatible con unidades SATA empresariales.1. Servidores de archivos empresarialesSi necesita almacenar grandes volúmenes de datos empresariales compartidos, la capacidad de 12 TB puede ayudarle a aumentar la densidad de almacenamiento sin tener que trasladar todas las cargas de trabajo a unidades SSD. 2. Almacenamiento de copias de seguridad y recuperación ante desastresEn el caso de los repositorios de copias de seguridad, la capacidad y el coste por terabyte suelen ser más importantes que la latencia ultrabaja.Por lo tanto, el Exos X18 puede ser una opción lógica como capa de almacenamiento de alta capacidad, siempre que la arquitectura general de la copia de seguridad esté diseñada correctamente. 3. Sistemas de almacenamiento RAIDLa grabación CMR y las especificaciones orientadas al ámbito empresarial hacen que la unidad sea relevante para grandes conjuntos de discos duros, siempre que sea compatible con el controlador y la plataforma. 4. Almacenamiento en centros de datosSi gestiona un gran número de unidades de disco, la densidad de capacidad, la capacidad de carga, la eficiencia energética y el funcionamiento predecible se convierten en criterios de compra importantes.El posicionamiento empresarial del Exos X18 y su arquitectura sellada con helio están diseñados pensando en este tipo de entorno. 5. Almacenamiento en la nube y a hiperescalaLa familia Exos X18 está diseñada para aplicaciones de almacenamiento empresarial y de hiperescala.Sin embargo, para implementaciones a gran escala, conviene evaluar la plataforma de almacenamiento completa en lugar de seleccionar las unidades de forma aislada. ¿Quiénes no deberían comprar un Exos X18 de 12 TB?Deberías pensártelo dos veces si tu requisito principal es una latencia extremadamente baja o un rendimiento de E/S aleatoria muy alto.Para cargas de trabajo como:Bases de datos de alto volumen de transaccionesAlmacenamiento temporal para entrenamiento de IANiveles de virtualización de alto IOPSAlmacenamiento de aplicaciones de baja latenciaCargas de trabajo de metadatos críticas para el rendimientoUna unidad SSD NVMe empresarial u otra unidad SSD empresarial podría ser más apropiada.La principal ventaja del Exos X18 reside en su almacenamiento HDD empresarial de alta capacidad, no en su capacidad para reemplazar las unidades SSD NVMe en cargas de trabajo donde la latencia es un factor crítico. Seagate Exos X18 de 12 TB frente a discos duros para consumidores¿Por qué elegirías un disco duro empresarial en lugar de un disco duro convencional para ordenadores de sobremesa?La respuesta es la carga de trabajo objetivo.Los discos duros para consumidores suelen estar optimizados para la informática personal y el almacenamiento general a un precio asequible.El Exos X18 está diseñado en función de los requisitos empresariales, tales como:Funcionamiento 24/7Altas cargas de trabajo anualesAlmacenamiento a gran escalaentornos RAIDImplementaciones en centros de datosRequisitos de confiabilidad empresarialLa documentación oficial de Seagate enumera las tecnologías y características orientadas a empresas en toda la familia Exos X18, incluyendo CMR, construcción sellada con helio, PowerChoice, PowerBalance y compatibilidad con conexión en caliente. Si está construyendo una matriz de almacenamiento crítica para el negocio, la comparación correcta no es simplemente:“¿Cuál es el disco duro de 12 TB más barato?” Una pregunta mejor sería:“¿Qué disco duro de 12 TB es el más adecuado para mi carga de trabajo, arquitectura de almacenamiento y entorno operativo previsto?” Seagate Exos X18 de 12 TB: Principales ventajas y limitacionesVentajasAlta capacidad de 12 TB: Puedes añadir una capacidad de almacenamiento considerable manteniendo un número de discos manejable.Diseño orientado a la empresa: El Exos X18 está diseñado para aplicaciones de almacenamiento empresarial, en lugar de para cargas de trabajo de escritorio convencionales.Registro de RMC: Útil para aplicaciones donde es importante un comportamiento de escritura consistente.7.200 RPM: Proporciona un equilibrio razonable entre rendimiento, capacidad y eficiencia operativa del disco duro.Caché de 256 MB: Proporciona almacenamiento en búfer adicional para cargas de trabajo de almacenamiento.Arquitectura sellada con helio: Admite el diseño de alta densidad de la familia Exos X18.Interfaz SATA de 6 Gb/s: Esto hace que el ST12000NM000J sea adecuado para servidores y sistemas de almacenamiento compatibles basados ​​en SATA. LimitacionesLatencia del disco duro:No puede competir con las unidades SSD NVMe empresariales en cuanto a latencia y E/S aleatoria.Compatibilidad específica de la interfaz:Debe verificar que su servidor o controlador sea compatible con SATA.Una capacidad bruta de 12 TB no siempre se traduce en 12 TB utilizables:RAID, el formateo del sistema de archivos y la sobrecarga del sistema reducen la capacidad disponible.Acústica y vibración de discos duros empresariales:Un disco duro de clase centro de datos puede no ser la opción ideal para un entorno doméstico o de oficina silencioso. ¿Cómo debería comprar un disco duro Seagate Exos X18 de 12 TB para un proyecto de servidor?Si va a comprar una unidad para evaluarla, el proceso es relativamente sencillo.Para una implementación en un negocio o centro de datos, el enfoque de la compra debe ser diferente.Paso 1: Confirme el número de pieza exacto.No haga el pedido simplemente buscando “Exos X18 12TB”.Confirma si necesitas:ST12000NM000J SATAo cualquier otro modelo como:ST12000NM004J SASLa documentación de Seagate confirma que se trata de variantes de interfaz diferentes. Paso 2: Confirmar la compatibilidad del servidorProporcione su:Marca del servidorModelo de servidorcontrolador RAIDPlano posteriorModelo de disco duro existenteCapacidad requeridaInterfazEsto permite a su proveedor comprobar la compatibilidad antes de que usted realice una compra al por mayor. Paso 3: Calcular la capacidad RAID utilizableSi va a comprar varios discos duros de 12 TB, calcule la capacidad útil en función de su nivel RAID en lugar de simplemente multiplicar 12 TB por el número de discos. Paso 4: Considere su carga de trabajo anualCompare la carga de trabajo prevista con la carga de trabajo nominal de la unidad.AILINK100 incluye el ST12000NM000J con una capacidad de carga anual de hasta 550 TB/año. Paso 5: Solicite una muestra antes de una implementación a gran escala.Para proyectos empresariales de mayor envergadura, probar una unidad de muestra en su servidor real y en su entorno RAID es una práctica de adquisición sensata.Puedes validar:detección de conducciónCompatibilidad del controlador RAIDComportamiento del firmwareInformación SMARTRendimiento sostenidoTemperaturaReconstruir el comportamientoEsto es mucho más seguro que descubrir un problema de compatibilidad después de comprar un lote completo. Veredicto final: ¿Merece la pena considerar el Seagate Exos X18 de 12 TB?El Seagate Exos X18 12TB ST12000NM000J es una excelente opción cuando la prioridad es el almacenamiento SATA empresarial de alta capacidad en lugar de la latencia propia de un SSD.Deberías considerarlo si necesitas:Capacidad de disco duro empresarial de 12 TBRendimiento a 7200 RPMRegistro de RMCConectividad SATA de 6 Gb/sAlmacenamiento compatible con RAIDImplementación en servidores o centros de datosAlta capacidad de carga de trabajo anualDensidad de almacenamiento a gran escala Deberías considerar alternativas de SSD o NVMe para empresas si tu carga de trabajo está dominada por E/S aleatorias, aplicaciones sensibles a la latencia o requisitos de IOPS muy altos. Lo más importante es no elegir la unidad basándose únicamente en su capacidad. Confirme el número de modelo exacto, la interfaz, la compatibilidad con el controlador, la carga de trabajo, el diseño RAID y el entorno de implementación antes de realizar su pedido. En concreto, AILINK100 cataloga el ST12000NM000J como un disco duro SATA empresarial Seagate Exos X18 de 12 TB con 7200 RPM, 256 MB de caché, grabación CMR e interfaz SATA de 6 Gb/s. Puede consultar la disponibilidad, el precio y la compatibilidad para su servidor o proyecto de almacenamiento en la página del producto. Preguntas frecuentes sobre el Seagate Exos X18 de 12 TB¿Es el Seagate Exos X18 de 12 TB un buen disco duro para empresas?Sí. La familia de discos duros Exos X18 es una gama empresarial diseñada para entornos de almacenamiento a gran escala. El modelo ST12000NM000J ofrece una capacidad de 12 TB, 7200 RPM, conectividad SATA de 6 Gb/s, grabación CMR y especificaciones para cargas de trabajo empresariales. ¿El Seagate Exos X18 de 12 TB es compatible con CMR?Sí. La familia Exos X18 utiliza grabación magnética convencional (CMR), incluido el modelo ST12000NM000J de 12 TB. ¿Es el Seagate Exos X18 de 12 TB adecuado para RAID?Sí, siempre que el servidor, el controlador RAID, el backplane, el firmware y la interfaz de la unidad sean compatibles. Está diseñado para aplicaciones de almacenamiento empresarial y RAID. ¿El ST12000NM000J es SATA o SAS?El modelo ST12000NM000J es la versión SATA de 12 TB a 6 Gb/s. La variante SAS de 12 TB es el modelo ST12000NM004J. ¿Qué tan rápido es el Seagate Exos X18 de 12 TB?La documentación del SATA Exos X18 especifica un rendimiento de transferencia sostenida de hasta aproximadamente 270 MB/s, dependiendo del modelo exacto y las condiciones de funcionamiento. ¿Es Exos X18 mejor que un SSD?No es una regla general. El Exos X18 es más adecuado para el almacenamiento en disco duro empresarial de alta capacidad y rentable, mientras que las unidades SSD empresariales suelen ser preferibles para cargas de trabajo que requieren una latencia muy baja y un alto número de operaciones de entrada/salida aleatorias (IOPS). ¿Se puede usar un Exos X18 de 12 TB en un servidor?Sí, siempre que el servidor, el bus, el controlador de almacenamiento, el firmware, el factor de forma, la interfaz y el formato de sector sean compatibles con la unidad específica. Para el ST12000NM000J, se requiere una arquitectura de almacenamiento SATA compatible. ¿Dónde se puede comprar el Seagate Exos X18 de 12 TB ST12000NM000J?AILINK100 ofrece actualmente el Seagate Exos X18 de 12 TB ST12000NM000J y brinda asistencia para consultas sobre el producto y la adquisición de almacenamiento empresarial. Para implementaciones de mayor tamaño, se recomienda proporcionar la configuración de su servidor o almacenamiento para verificar la compatibilidad antes de la compra.
  • Los mejores discos duros empresariales de 2026 para almacenamiento escalable
    Los mejores discos duros empresariales de 2026 para almacenamiento escalable
    August 13, 2026
    Necesitas los mejores discos duros empresariales en 2026 para escalar de manera eficiente una infraestructura de servidores masiva. Los entornos de almacenamiento en la nube de alta densidad requieren unidades probadas como Seagate Exos Serie X, Western Digital Gold y Toshiba Serie MG. Estos discos duros empresariales soportan cargas de trabajo intensas y continuas en su centro de datos.Su estrategia de adquisición debe evaluar métricas críticas que vayan más allá del costo inicial por terabyte. Debe adecuar la capacidad de carga de las unidades a los requisitos de su sistema al elegir las opciones de interfaz SAS o SATA para cada chasis de servidor. Los modernos discos duros mecánicos de alta capacidad garantizan la fiabilidad operativa durante todo el año. Seleccionar el hardware adecuado protege su inversión en almacenamiento escalable. Conclusiones claveSeleccione discos duros de alta capacidad como Seagate Exos o WD Gold para escalar su centro de datos de manera eficiente.Asegúrese de que las interfaces de las unidades SAS o SATA sean compatibles con el chasis de su servidor y los requisitos de la carga de trabajo.Combine unidades de estado sólido de alta velocidad con discos duros mecánicos para crear un sistema de almacenamiento escalonado equilibrado.Los diseños de accionamiento sellados con helio reducen la fricción interna del gas y disminuyen el consumo total de energía en un cincuenta por ciento. Los mejores discos duros empresariales para 2026Necesitas los mejores discos duros empresariales para gestionar los crecientes volúmenes operativos en toda tu infraestructura. Seleccionar discos duros de alta capacidad almacenamiento empresarial duro Las unidades de disco permiten que su centro de datos alcance la máxima eficiencia. Los chasis de servidores modernos dependen de unidades de disco especializadas diseñadas para cargas de trabajo continuas e intensas. Unidades de alta gama para una gran densidad de datos.Los principales fabricantes ofrecen opciones excepcionales de discos duros para servidores, diseñados para entornos de rack exigentes. Seagate ofrece la máxima capacidad de discos duros para servidores a través de su plataforma Mozaic 3+ HAMR, alcanzando los 32 TB con la unidad Exos M ST32000NM000K. También puede implementar el Seagate Exos M ST30000NM004K de 30 TB SATA o el Exos X24 ST24000NM007H de 24 TB SAS.Western Digital amplía sus opciones de discos duros empresariales con la unidad WD Gold de 26 TB, que utiliza las tecnologías ePMR y OptiNAND. Por su parte, Toshiba ofrece la serie MG11 de 24 TB con tecnología FC-MAMR y una caché de 1 GB. La siguiente tabla compara estos modelos líderes según las especificaciones clave de los discos duros para servidores:ModeloCapacidadInterfazCalificación de carga de trabajoVelocidad de giroSeagate Exos M ST32000NM000K32 TBSATA 6 Gb/s550 TB/año7200 RPMSeagate Exos M ST30000NM004K30 TBSATA 6 Gb/s550 TB/año7200 RPMWD Gold 26TB26 TBSATA 6 Gb/s550 TB/año7200 RPMToshiba MG1124 TBSATA 6 Gb/s550 TB/año7200 RPMCada opción de disco duro empresarial incluye características esenciales como protección contra vibraciones rotacionales y garantías de 5 años. Estas características garantizan la estabilidad del sistema al instalar decenas de unidades dentro de una misma carcasa de servidor. Comparación del rendimiento de los modelos líderesEvaluar la velocidad de los discos duros mecánicos le ayuda a elegir el disco duro adecuado para su carga de trabajo operativa. Las velocidades de lectura y escritura varían según la tecnología, como se muestra en las pruebas de los fabricantes y en las evaluaciones independientes.Modelo de transmisiónVelocidad nominalLectura secuencial independienteEscritura secuencial independienteSeagate Exos M de 30 TB275 MB/s292 MB/s289 MB/sWestern Digital Gold de 26 TB288 MiB/s (~302 MB/s)283–285 MB/sNo se informóToshiba MG11 24TB295 MiB/s (~309 MB/s)Datos limitadosNo se informóEl rendimiento secuencial representa solo un aspecto del rendimiento general de la unidad. También debe evaluar las IOPS de acceso aleatorio al configurar un servidor para aplicaciones de almacenamiento en la nube mixtas. Las unidades mecánicas estándar ofrecen IOPS aleatorias moderadas en comparación con Unidades SSD de nivel empresarial para centros de datosSin embargo, las unidades de disco duro de alta densidad para servidores siguen siendo esenciales para la retención masiva de datos de forma rentable.Como muestra el gráfico, el disco duro Seagate IronWolf Pro de 22 TB y 7200 RPM alcanza aproximadamente 210 IOPS de lectura aleatoria de 4K y aproximadamente 230 IOPS de escritura aleatoria de 4K. El Seagate Exos X20 de 18 TB alcanza aproximadamente 190 IOPS de lectura aleatoria de 4K y aproximadamente 210 IOPS de escritura aleatoria de 4K. El disco duro WD Red Plus de 14 TB y 5400 RPM se queda atrás con aproximadamente 150 IOPS de lectura aleatoria de 4K y aproximadamente 170 IOPS de escritura aleatoria de 4K.La integración de unidades HDD de servidor de alto rendimiento junto con niveles de caché SSD crea arquitecturas de almacenamiento equilibradas. Las funciones empresariales avanzadas, como la limitación térmica, controlan el estado de las unidades en racks de alta densidad. Además, las funciones de cifrado de hardware protegen los datos confidenciales en implementaciones de servidores activos. Elegir los mejores discos duros empresariales garantiza capacidad escalable, durabilidad a largo plazo y un rendimiento constante para su flota de discos duros empresariales. Criterios clave de selección para discos duros empresarialesAntes de adquirir discos duros empresariales de alta capacidad para su sistema de almacenamiento, debe evaluar factores técnicos clave. Seleccionar la arquitectura de disco adecuada evita cuellos de botella en el sistema y maximiza la densidad física. Capacidad, interfaz y velocidad de rotaciónLa selección de la interfaz define la topología general del sistema y determina la velocidad de comunicación. La infraestructura empresarial se basa principalmente en los protocolos Serial Attached SCSI (SAS) y Serial ATA (SATA).Un controlador SAS o un backplane aceptan unidades SATA, pero un controlador SATA nunca aceptará una unidad SAS.Esta regla de diseño de hardware rige la coincidencia de conexiones en cada gabinete de rack. Un disco duro SAS empresarial de doble puerto proporciona redundancia de rutas múltiples para operaciones de misión crítica, mientras que SATA ofrece conexiones rentables para grandes volúmenes de datos. Debe seleccionar SSD de grado empresarial para centros de datos cuando sus cargas de trabajo requieran tiempos de acceso inferiores a un milisegundo. Sin embargo, las unidades mecánicas ofrecen una eficiencia de almacenamiento superior en términos de costo por terabyte. La velocidad de rotación del husillo impacta directamente en la latencia de acceso y el rendimiento secuencial, como se describe en la siguiente tabla:Velocidad del husilloClaseFortalezasLo mejor para7200 RPMLínea media / línea cercana (3,5")Máxima capacidad, menor coste por TB, bajo consumo energético.Copias de seguridad, archivos, almacenamiento masivo en frío10.000 RPMEmpresa (2,5")Equilibrio entre velocidad, capacidad y densidad.Cargas de trabajo de propósito general y de rendimiento moderado.15.000 RPMRendimiento empresarial (2,5")Latencia de HDD más baja, IOPS de HDD más altasNecesidades de rendimiento heredadasAumentar la velocidad del husillo de 7200 RPM a 10 000 RPM reduce la latencia de rotación promedio de 4,17 ms a 3,00 ms. Las velocidades de rotación más altas incrementan el consumo de energía y la generación de calor en configuraciones de chasis densas. Por lo tanto, las unidades nearline de 7200 RPM proporcionan la capacidad principal de alta densidad necesaria para grandes grupos de almacenamiento de servidores. Evaluar las especificaciones de resistencia garantiza que la configuración del disco duro de su servidor gestione el tráfico de escritura previsto sin fallos inesperados. Las clasificaciones de carga de trabajo miden la resistencia mediante el total de bytes escritos (TBW) o las escrituras de la unidad por día (DWPD). Ajustar la resistencia de la unidad al volumen de escritura diario mantiene la estabilidad general del servidor. Horas de funcionamiento, MTBF y características de fiabilidadLos sistemas de centros de datos requieren un funcionamiento ininterrumpido, por lo que la durabilidad del hardware de las unidades es fundamental. Los discos duros empresariales modernos soportan las exigencias operativas continuas gracias a rigurosos estándares de fabricación. Los administradores de sistemas comienzan a planificar el reemplazo cuando se alcanzan entre 25 000 y 30 000 horas de funcionamiento (POH) para evitar tiempos de inactividad inesperados del hardware. Puede evaluar las probabilidades estadísticas de fallo utilizando fórmulas de fiabilidad establecidas:Métrica de confiabilidadFórmulaImpacto en la selecciónMTBF (Tiempo medio entre fallos)Tiempo total de funcionamiento entre fallos / número de fallosValores más altos indican una mayor vida útil esperada y un menor riesgo de tiempo de inactividad.Tasa de carga de trabajo anual(Escritos de por vida + Lecturas de por vida) * (8760 / Horas de encendido de por vida)Superar los límites de transferencia nominales acelera el desgaste y anula las garantías.El diseño del hardware incorpora funciones empresariales especiales para proteger los conjuntos de unidades de accionamiento de alta densidad. Los sensores de vibración rotacional integrados detectan el movimiento externo del chasis. El controlador interno ajusta la posición del actuador para contrarrestar las perturbaciones dinámicas de las unidades de accionamiento adyacentes.La recuperación de errores con límite de tiempo (TLER, por sus siglas en inglés) limita los intentos de recuperación de sectores defectuosos a aproximadamente 7 segundos, notificando inmediatamente al controlador RAID de hardware para preservar la estabilidad de la matriz.Estas funciones empresariales optimizan la gestión de errores de las unidades, manteniendo la capacidad de respuesta del servidor incluso bajo cargas pesadas. Los protocolos de cola de firmware especializados mejoran el rendimiento multicliente durante la ejecución de comandos en paralelo. Funciones empresariales como el estacionamiento activo de cabezales, los algoritmos avanzados de protección de datos y la gestión automatizada de energía reducen los riesgos operativos. Seleccionar hardware con funciones empresariales robustas garantiza la fiabilidad operativa en toda la infraestructura de discos duros de su servidor. Adaptación de la carga de trabajo y arquitectura de la unidadRequisitos de interfaz SAS frente a SATADebe seleccionar el disco duro del servidor según sus necesidades operativas específicas. Los discos duros empresariales con interfaz SAS admiten velocidades de transferencia de hasta 12-24 Gbps y ofrecen detección y corrección de errores avanzadas. Por otro lado, los discos duros SATA para servidores ofrecen velocidades de transferencia de hasta 6 Gbps, junto con funciones básicas de corrección de errores. Un disco duro SAS es ideal para bases de datos críticas, plataformas de comercio electrónico y clústeres de máquinas virtuales que requieren transacciones multihilo sin latencia.Los administradores de almacenamiento implementan unidades de estado sólido (SSD) cuando las operaciones de carga de trabajo requieren acceso instantáneo a los datos. La implementación de matrices SSD rápidas junto con almacenamiento nearline crea una topología equilibrada. La evaluación de la durabilidad de las unidades previene fallas prematuras de hardware en entornos de escritura continua. Las aplicaciones con uso intensivo de lectura requieren índices de durabilidad más bajos, alrededor de 1 DWPD o menos. Las cargas de trabajo de uso mixto requieren una durabilidad de 3 DWPD para el procesamiento transaccional. Las canalizaciones de ingesta de datos con uso intensivo de escritura requieren índices de 10 DWPD para soportar escrituras diarias intensas. Esta estratificación estratégica optimiza el rendimiento general del sistema en todos los nodos de almacenamiento. Tecnologías de helio e innovaciones en actuadoresEl sellado con helio aumenta la capacidad de la unidad al eliminar la turbulencia del aire interno. El sellado con gas inerte dentro del chasis permite alojar nueve discos delgados en un marco de disco duro estándar de 3,5 pulgadas para servidores. Las unidades Toshiba serie MG08 selladas con helio reducen el consumo de energía por gigabyte en aproximadamente un 50 % en comparación con los diseños de discos duros con aire. La reducción del consumo de energía amplía la capacidad del rack a la vez que mantiene temperaturas de funcionamiento seguras en cada chasis de servidor. Las funciones avanzadas para empresas protegen el posicionamiento del cabezal de la unidad contra vibraciones continuas.Las innovaciones en los actuadores mantienen un posicionamiento preciso del cabezal en discos magnéticos densamente empaquetados. Los actuadores de doble etapa combinan un miliactuador de 200 nm y un microactuador de 100 nm para una alineación precisa de las pistas. Los conjuntos de múltiples actuadores, como el Seagate MACH.2, duplican el rendimiento de IOPS y mejoran el rendimiento secuencial, a la vez que ofrecen velocidades de lectura sostenidas de hasta 480 MB/s. Estas características empresariales especializadas equilibran la ejecución mecánica del disco duro del servidor con el almacenamiento en caché secundario de la SSD. La implementación de cada disco duro de servidor de alta densidad con características empresariales modernas mantiene una alta fiabilidad del servidor. Implementación de unidades en infraestructura escalableIntegración dentro de los sistemas de almacenamiento por nivelesPuedes crear una infraestructura de almacenamiento de datos escalable combinando unidades SSD de nivel empresarial para centros de datos con discos duros de almacenamiento empresarial de alta capacidad. Las arquitecturas híbridas modernas implementan unidades de estado sólido rápidas o una unidad SSD empresarial dedicada en el borde de la red. Las funciones empresariales integradas permiten que esta capa dirija las escrituras rápidas en ráfaga a una capa de caché SSD de alta velocidad. Como resultado, tu sistema de almacenamiento procesa las solicitudes de lectura y escritura entrantes con una latencia mínima, protegiendo al mismo tiempo las matrices de discos principales.El controlador de almacenamiento traslada los archivos de datos más antiguos a un grupo de discos duros de servidor para su retención a largo plazo. Por ejemplo, los grandes clústeres de entrenamiento de IA implementan 46 PB de caché NVMe en 6080 GPU para maximizar el rendimiento de la carga de trabajo durante las operaciones activas. Las tareas de punto de control escriben datos temporales en memoria flash de alta velocidad antes de migrar esos archivos a grandes matrices de discos duros de servidor. Esta implementación por niveles protege la resistencia a la escritura y optimiza la capacidad total de las unidades en su red de almacenamiento en la nube. Densidad del chasis, gestión térmica y expansiónLos chasis de alta densidad requieren un control ambiental adecuado para proteger el hardware del servidor del desgaste físico. La instalación de un disco duro de servidor en un chasis de rack de alta densidad genera altas cargas térmicas y vibraciones acústicas. Las fuertes vibraciones mecánicas reducen la precisión de lectura de la unidad y obligan al actuador interno a realinearse constantemente. Es fundamental supervisar las métricas de resistencia a la escritura del disco duro del servidor y activar funciones empresariales especializadas para mantener el rendimiento del sistema bajo cargas operativas continuas.Puede mitigar las tensiones físicas utilizando métodos de gestión de recintos específicos:Configure los perfiles de los ventiladores para mantener las unidades de disco duro en reposo por debajo de los 45 °C.Utilice bandejas de montaje antivibración para lograr una reducción de vibraciones de 12 a 18 dB.Habilite los temporizadores de arranque secuenciales para eliminar los picos de impulso transitorios al encender el dispositivo.Implemente un sistema de refrigeración líquida de inmersión de precisión para igualar las temperaturas de las unidades y mantener el máximo rendimiento del disco duro.Conectar una matriz de almacenamiento en red (NAS) amplía la capacidad total sin reducir la vida útil de las unidades con el tiempo. Los protocolos de firmware integrados gestionan el estacionamiento de cabezales en segundo plano y las lecturas de vigilancia para mantener la integridad de la matriz. Los equipos de servidor modernos utilizan funciones empresariales avanzadas para aislar las vibraciones del chasis de múltiples unidades. Implementar cada disco duro del servidor con velocidades de rotación coincidentes garantiza un rendimiento predecible en toda su infraestructura en expansión. Seleccionar lo mejor discos duros empresariales Requiere equilibrar la alta capacidad con la fiabilidad del hardware a largo plazo. Debe evaluar los costos iniciales de adquisición junto con el consumo de energía continuo y las demandas de carga de trabajo. La infraestructura de datos moderna se basa en adaptar cada unidad de servidor a las demandas de carga de trabajo activas. Debe equilibrar las unidades de disco duro empresariales de alta densidad con el almacenamiento flash para optimizar el rendimiento del sistema.Antes de realizar su pedido, debe confirmar la compatibilidad total del hardware. Verifique que el adaptador de bus de su host sea compatible con el protocolo de unidad seleccionado. Además, asegúrese de que el backplane y el chasis de su servidor cumplan con los requisitos térmicos y de vibración. Verificar estos requisitos del servidor antes de la implementación protege su inversión en infraestructura y garantiza un rendimiento operativo ininterrumpido. Preguntas frecuentes¿Debería elegir discos duros de almacenamiento empresarial de alta capacidad SAS o SATA?Para cargas de trabajo críticas que requieren redundancia de doble puerto y velocidades de transferencia de hasta 12-24 Gbps, elija SAS. Para una retención de datos masiva rentable con velocidades de transferencia de hasta 6 Gbps, seleccione SATA. Confirme que el adaptador de bus de su host sea compatible con la interfaz seleccionada.¿Cómo funcionan las unidades SSD de nivel empresarial para centros de datos con las unidades mecánicas?Puedes combinar unidades SSD de alto rendimiento para centros de datos con discos mecánicos en una arquitectura por niveles. La rápida capa de estado sólido gestiona las ráfagas de escritura entrantes y las frecuentes solicitudes de lectura. Posteriormente, tu sistema transfiere los datos menos utilizados a los discos mecánicos para un almacenamiento escalable a largo plazo.¿Por qué las unidades de disco duro de alta densidad para servidores utilizan tecnología de helio?El helio sellado reduce la fricción interna del gas y la turbulencia del aire dentro del chasis. Este diseño permite a los fabricantes alojar hasta nueve discos delgados en un bastidor de unidad estándar de 3,5 pulgadas. La tecnología reduce el consumo de energía por gigabyte en aproximadamente un 50 %, manteniendo temperaturas de funcionamiento seguras.¿Qué es la recuperación de errores con límite de tiempo (TLER, por sus siglas en inglés) en los sistemas RAID?La recuperación de errores con límite de tiempo restringe los intentos de recuperación de sectores defectuosos de la unidad a aproximadamente 7 segundos. El controlador de la unidad notifica rápidamente al controlador RAID de hardware sobre los problemas de sector. Este proceso evita la desconexión de la unidad del arreglo y mantiene la estabilidad general del sistema de almacenamiento bajo cargas operativas intensas.
  • Aprende a elegir el módulo de memoria DDR5 ECC adecuado para servidores.
    Aprende a elegir el módulo de memoria DDR5 ECC adecuado para servidores.
    August 05, 2026
    Seleccionar la mejor memoria RAM DDR5 requiere evaluar la arquitectura del módulo, la velocidad de transferencia, la capacidad por zócalo, la eficiencia de voltaje y las demandas de carga de trabajo empresarial. Los servidores modernos de alto rendimiento dependen de subsistemas de memoria avanzados para admitir plataformas como Intel Xeon Scalable y AMD EPYC. Implementar una Módulo de memoria de servidor DDR5 Proporciona un ancho de banda excepcional y una latencia ultrabaja para operaciones de centros de datos de misión crítica. Al actualizar la memoria RAM de un servidor, mejora de inmediato la fiabilidad del sistema y la integridad de la ruta de datos del bus. La tecnología DDR5 de última generación incorpora corrección de errores integrada para evitar interrupciones inesperadas del hardware. Proteja la infraestructura de su empresa mediante actualizaciones planificadas de servidores. Una densidad de memoria adecuada garantiza un rendimiento empresarial óptimo incluso bajo cargas de trabajo intensas y continuas. Conclusiones claveLa actualización a memoria DDR5 para servidores aumenta el ancho de banda del sistema y reduce el consumo de energía gracias a su eficiente funcionamiento a 1,1 V.La elección de arquitecturas de módulos modernas, como RDIMM o MRDIMM, optimiza la velocidad de los datos para cargas de trabajo empresariales intensas.Las funciones avanzadas de corrección de errores protegen la integridad de los datos y evitan costosos tiempos de inactividad del sistema en los centros de datos.La distribución simétrica de los canales de memoria garantiza la máxima velocidad de procesamiento y mantiene la estabilidad general del servidor.Comprensión de los tipos y arquitecturas de módulos DDR5Seleccionar la arquitectura correcta del módulo de memoria del servidor garantiza la estabilidad operativa en los servidores empresariales. Es fundamental comprender las diferencias en el diseño físico de la memoria del servidor para optimizar las inversiones en hardware moderno. Las distintas cargas de trabajo empresariales requieren opciones de memoria personalizadas en toda la infraestructura para lograr la máxima eficiencia. Mecánica de RDIMM vs LRDIMM vs MRDIMMTipo de memoriaComponentes estructurales claveMecánica y capacidades operativasAplicaciones objetivoRDIMMBúfer de registro integradoAlmacena en búfer las señales de comando, dirección y reloj para reducir la carga eléctrica en el controlador de memoria, lo que añade aproximadamente un ciclo de reloj de latencia.Hardware de servidor estándar y sistemas de alta fiabilidadLRDIMMRegistro del controlador de reloj y los búferes de datosLos búferes controlan las señales y reenvían las líneas de datos a través de ellos, ocultando los chips DRAM sin procesar al controlador para maximizar los límites de carga pesada.Hardware de servidor estándar e implementaciones de alta densidad.MRDIMMLógica de control y búfer de multiplexación en DIMMOpera simultáneamente dos rangos a través de un multiplexor, duplicando efectivamente el rendimiento del canal más allá de las velocidades nativas de ddr5 (por ejemplo, ~70,4 GB/s a 8800 MT/s).Inteligencia artificial, computación de alto rendimiento (HPC) y plataformas de servidores de próxima generación.Los módulos de memoria en línea dual de rango multiplexado utilizan un búfer de multiplexación integrado en el DIMM, junto con una lógica de control dedicada, para combinar operaciones DDR5 de doble rango. Al gestionar simultáneamente flujos de datos en múltiples rangos de memoria, estos módulos avanzados superan los límites de velocidad estándar de la DDR5. Se obtiene un mayor rendimiento de datos, menor latencia, mayor capacidad efectiva y una eficiencia energética mejorada por vatio. Estos módulos entregan una carga útil de datos de 128 bytes al procesador durante cada ciclo, duplicando la capacidad de carga útil de 64 bytes de los módulos DDR5 estándar durante operaciones de computación continua.Los módulos MRDIMM integran tecnología de multiplexación de alta velocidad para permitir el acceso simultáneo a los diferentes rangos de memoria en lugar de procesar las operaciones de forma secuencial, como en el entrelazado de memoria estándar, duplicando así la velocidad de datos efectiva por pin y maximizando el ancho de banda.Acceso concurrente a rangos: la arquitectura MRDIMM permite la activación y la obtención simultáneas entre pares de rangos DRAM, lo que aumenta sustancialmente el rendimiento en comparación con las operaciones estándar de un solo rango ddr5.Multiplexación de flujo de datos: Incorpora componentes especializados para combinar canales de datos, duplicando efectivamente la velocidad de transferencia de datos por pin (por ejemplo, aumentando una frecuencia DRAM nativa de 6400 MT/s a una velocidad de interfaz de 12 800 MT/s). Evaluación de topologías de canales y estructuras de rangoLas arquitecturas de doble rango (2Rx4), como las que se encuentran en los módulos DDR5 de 64 GB para empresas, logran un equilibrio óptimo entre la integridad de la señal y los límites de expansión. Las estructuras de doble rango permiten que las arquitecturas de sistema mantengan una calidad de señal nítida a la vez que impulsan una mayor densidad en las ranuras de memoria ocupadas. Los arquitectos de sistemas también deben evaluar el impacto de la topología del canal en las frecuencias de operación al diseñar nodos de servidor. Elegir diseños de rango equilibrado evita la degradación de la señal durante tareas de computación intensivas y simplifica el mantenimiento del servidor a lo largo del tiempo. En la plataforma Eagle Stream de Intel, aumentar la densidad de canales de 1DPC a 2DPC establece límites máximos de frecuencia operativa DDR5 de 4400 MT/s para los procesadores Xeon Scalable de cuarta generación y de 4800 MT/s para los de quinta generación. Sin embargo, para determinados procesadores de gama media y de entrada con una velocidad inferior a 4800 MT/s en 1DPC (como los que funcionan a 4000 MT/s o 4400 MT/s), la transición a una topología 2DPC no supone ninguna pérdida de frecuencia. Es posible implementar configuraciones 2DPC para igualar directamente las velocidades operativas de 1DPC, lo que garantiza la fiabilidad del sistema a largo plazo y un rendimiento estable en todos los entornos de nube empresarial sin comprometer el ancho de banda total del bus.Adaptación de las cargas de trabajo empresariales a los módulos de memoria DDR5Las plataformas empresariales modernas requieren un ancho de banda escalable para gestionar operaciones de computación continuas. Actualizar los nodos de sus servidores con la mejor memoria RAM DDR5 aumenta significativamente el rendimiento en entornos de TI críticos. La implementación de un módulo de memoria de servidor avanzado proporciona un alto rendimiento y ayuda a maximizar la densidad del hardware. Los módulos de memoria DDR5 de alta densidad eliminan los cuellos de botella de datos en aplicaciones que consumen mucha memoria. Configuraciones de velocidad, latencia y rango de la memoria RAM DDR5La frecuencia de la memoria influye directamente en la latencia del sistema y en el rendimiento general de la empresa. Se obtiene la máxima velocidad del canal de memoria al elegir módulos con perfiles de temporización bajos y diseños de doble rango optimizados. La memoria DDR5 de alta velocidad mejora la eficiencia del núcleo del procesador en cargas de trabajo complejas.EspecificaciónDetalleEstándar y tecnología de memoriaDDR5 PC5-44800Velocidad y ancho de banda5600 MT/s a 44800 MB/sFactor de forma y pinesDIMM registrado (RDIMM), 288 pinesCorrección de errores y clasificaciónRegistrado en ECC, 2Rx4Voltaje y tiempos1,1 V, latencia CAS 40 Para establecer una base de rendimiento sólida, considere lo siguiente: Módulo RDIMM Samsung M321R8GA0PB0-CWMCJEste módulo funciona a una velocidad de 5600 MT/s y opera con una latencia CAS de 40 ciclos. La arquitectura de doble rango 2Rx4 equilibra las cargas eléctricas en las pistas de la placa base del servidor. Su funcionamiento a 1,1 V reduce la generación de calor dentro del chasis del servidor, manteniendo al mismo tiempo una alta velocidad en los canales de memoria.Alto rendimiento de datos: Opera a 5600 MT/s para proporcionar un procesamiento rápido para las cargas de trabajo empresariales.Mayor fiabilidad: La tecnología ECC integrada ayuda a prevenir fallos del sistema al identificar y corregir errores de memoria.Capacidad escalable: Proporciona 64 GB de memoria por módulo para gestionar aplicaciones de servidor multitarea y que consumen muchos recursos.Optimización empresarial: Presenta un diseño de rango 2Rx4 combinado con los estándares PC5-44800 para compatibilidad con servidores. Dimensionamiento de la memoria para IA, bases de datos y virtualizaciónLas aplicaciones empresariales requieren un rendimiento de datos masivo y una latencia de memoria constante. La implementación de memoria RAM DDR5 de alta velocidad acelera los procesos de análisis de big data y las respuestas a las consultas de bases de datos. Los marcos de aprendizaje automático procesan grandes parámetros con mayor rapidez cuando el sistema cuenta con la velocidad de la memoria DDR5. El ancho de banda de alta velocidad de la memoria RAM DDR5 mantiene los núcleos del procesador completamente saturados durante las tareas de entrenamiento intensivas.La selección de módulos DDR5 de 64 GB permite a los administradores de sistemas maximizar la memoria disponible por socket, manteniendo al mismo tiempo una baja latencia durante cargas de trabajo paralelas intensas.Compatibilidad con virtualización: Ofrece una capacidad de alta densidad de 64 GB, adaptada a las necesidades de virtualización empresarial.Rendimiento del servidor: Ofrece velocidades DDR5-5600 diseñadas para aliviar los cuellos de botella de rendimiento en las plataformas de servidores modernas.Eficiencia energética: Funciona con un bajo consumo de 1,1 V, lo que reduce significativamente la generación de calor y el consumo de energía en los racks de servidores. Los grandes motores de bases de datos requieren perfiles de latencia estables para procesar consultas de usuarios concurrentes. Un dimensionamiento adecuado de la capacidad evita los ciclos de intercambio de discos que degradan la capacidad de respuesta del sistema. Las plataformas de nube virtualizadas se benefician enormemente de las actualizaciones de servidores de alta densidad. Una planificación precisa de la expansión de la capacidad de memoria garantiza una densidad estable de máquinas virtuales en todos los hipervisores. Se logra un rendimiento mejorado en toda la infraestructura empresarial al adaptar las demandas de carga de trabajo a arquitecturas de memoria de alta velocidad. Los modernos módulos DDR5 proporcionan la base ideal para operaciones de computación escalables en centros de datos. Optimización de la arquitectura del canal del servidor para un rendimiento máximo.Para lograr el máximo rendimiento del servidor, es necesario distribuir adecuadamente los canales en los procesadores modernos. Debe equilibrar cuidadosamente los canales de memoria física para maximizar el ancho de banda del sistema en sistemas de alto rendimiento. Servidor empresarials Confía en configuraciones de canales equilibradas para procesar tareas de computación sin alcanzar cuellos de botella en el sistema. Cálculo de la población y la capacidad del canalLa correcta asignación de canales determina el rendimiento del sistema en las plataformas empresariales. El rendimiento se optimiza asignando sistemáticamente los canales de memoria del servidor según las estrictas directrices del procesador.Rellene los canales de memoria por zócalo en cantidades precisas de 1, 2, 4, 6, 8, 10 o 12.Instale módulos de memoria idénticos en todos los canales activos para mantener una configuración uniforme de los canales.Asegúrese de que la configuración de los módulos DIMM sea exactamente la misma en todos los zócalos de procesador de su servidor.Mantenga configuraciones de memoria idénticas en todos los dominios NUMA con la configuración NPS2 o NPS4.La máxima capacidad evita ralentizaciones importantes del sistema durante operaciones que consumen mucha memoria, como la virtualización o el procesamiento de grandes conjuntos de datos. Añadir suficiente RAM evita la disminución del rendimiento del sistema causada por el uso de memoria virtual o la paginación del sistema operativo. Se garantiza una ejecución fiable en todos los servidores empresariales al cumplir con los requisitos de canal por socket. Gestión del rendimiento en configuraciones multi-DIMMLas configuraciones multi-DIMM implican compromisos físicos entre la velocidad de procesamiento, la latencia y el consumo energético general. Los módulos DDR5 modernos incorporan módulos de regulación de voltaje integrados en el chip que operan a un voltaje base de 1,1 V. Este diseño logra un ahorro energético teórico de aproximadamente un 15-20 % en comparación con los 1,2 V de las arquitecturas DDR4. Los valores de latencia CAS más altos, como CL40 a CL42, introducen ligeros retrasos en el ciclo de reloj antes de que comience el acceso a los datos. Los patrones de acceso secuencial, como la codificación de vídeo, aprovechan el alto ancho de banda de la DDR5 con una penalización mínima en la latencia. Por el contrario, las tareas no secuenciales, como el procesamiento de imágenes en tiempo real, sufren retrasos debido al aumento de la latencia.La división de los módulos DIMM DDR5 en múltiples subcanales optimiza el flujo de datos simultáneo. Este paralelismo interno oculta la latencia de la DRAM durante las operaciones paralelas. Al seleccionar un módulo de memoria DDR5 balanceada, se mantiene una arquitectura de memoria de servidor eficaz para preservar la estabilidad general del sistema. Características clave de fiabilidad y potencia en la memoria RAM DDR5El hardware de los centros de datos requiere una fiabilidad operativa continua bajo cargas de procesamiento intensivas. Las aplicaciones empresariales modernas exigen sólidos mecanismos de protección para prevenir fallos del sistema e interrupciones operativas. La selección de hardware avanzado dota a su infraestructura en la nube de una estabilidad de nivel empresarial y un control térmico sostenido. Corrección de errores ECC integrada en el chip y corrección de errores de banda lateralDimensión técnicaECC en el chipECC del bus DRAM de banda lateralAlcance de la coberturaSolo chip DRAM internoRuta de datos completa (chip, PCB, controlador de memoria)Propósito fundamentalMejora la fiabilidad de los chips a medida que se reduce el tamaño de las celdas.Garantiza la integridad de los datos de extremo a extremo.Protección durante el transporteNingunoProtección activa de la ruta de transmisiónCapacidad de correcciónErrores de un solo bit (SEC)Corrección de errores simples, detección de errores dobles (SEC-DED)La tecnología DDR5 de última generación incorpora protección interna de celdas directamente en el chip DRAM. El chip calcula y almacena 8 bits de corrección de errores internos por cada 128 bits de datos. Este mecanismo corrige localmente los errores de un solo bit durante las operaciones de lectura. Sin embargo, los esquemas locales ignoran los errores en la ruta de transmisión. Los servidores empresariales combinan protección interna con código de corrección de errores de banda lateral para asegurar toda la ruta de datos. Esta protección integral del bus corrige los errores de transmisión entre el controlador de memoria y el módulo. En conjunto, estos mecanismos mejoran la fiabilidad del hardware y reducen en un 18 % los fallos relacionados con la memoria en entornos críticos. De esta forma, se protege la integridad general de los datos en todos los canales de computación activos. Eficiencia térmica y del circuito integrado de gestión de energía (PMIC) en el móduloLos módulos de memoria tradicionales dependían de los circuitos de la placa base para la regulación de voltaje. La memoria RAM DDR5 moderna traslada la regulación de energía directamente al módulo de memoria mediante un circuito integrado de administración de energía (PCI) integrado. El controlador integrado recibe una entrada de 5 V y la reduce localmente a 1,1 V.Rutas de suministro de energía más cortas: La regulación integrada en el módulo acorta la longitud de las pistas eléctricas y reduce la resistencia de las mismas.Respuesta dinámica más rápida: el control de potencia localizado responde rápidamente a las demandas de procesamiento cambiantes.Control de voltaje más preciso: La regulación local reduce el ruido eléctrico y evita la pérdida de voltaje.Al reducir el voltaje de funcionamiento de 1,2 V a 1,1 V, se obtiene una disminución del 15 % en el consumo de energía de la memoria en comparación con los estándares anteriores. Este menor consumo energético minimiza la generación de calor en chasis empresariales de alta densidad. La elección de memoria RAM DDR5 de alta densidad reduce las necesidades de refrigeración en entornos de racks densos. Esta gestión inteligente de la energía optimiza el coste total de propiedad a la vez que mantiene un rendimiento óptimo del sistema. La memoria RAM DDR5 de alta densidad ofrece una fiabilidad y eficiencia energética excepcionales para servidores empresariales exigentes. Optimice la adquisición de memoria para servidores equilibrando las demandas de carga de trabajo, los objetivos de densidad y los límites presupuestarios. Seleccionar el módulo de memoria adecuado garantiza el éxito operativo a largo plazo. Debe consultar las listas de proveedores cualificados de placas base antes de adquirir hardware DDR5. Las opciones de memoria no verificadas provocan bloqueos durante la inicialización y reinicios espontáneos del sistema. Las pruebas del proveedor validan la estabilidad de los chips de memoria bajo cargas de procesamiento elevadas. Una actualización planificada de la memoria RAM del servidor mejora el rendimiento general del procesamiento. El uso de componentes DDR5 de 1,1 V de bajo consumo reduce el consumo de energía y la generación de calor en los racks del centro de datos. La gestión estratégica de rangos maximiza el ancho de banda en los canales activos. Una planificación cuidadosa de la memoria DDR5 protege la fiabilidad de su infraestructura durante las actualizaciones críticas de los servidores. Una planificación inteligente de las actualizaciones optimiza el coste total de propiedad a lo largo del tiempo. Preguntas frecuentes¿Por qué debería elegir memoria RAM DDR5 para sus servidores empresariales?Los servidores modernos requieren un procesamiento rápido para tareas de computación intensivas. La implementación de memoria RAM DDR5 aumenta el ancho de banda total del sistema. La tecnología DDR5 de última generación incrementa la fiabilidad operativa. Además, reduce el consumo energético general gracias a su eficiente funcionamiento a 1,1 V.¿Cómo mejora el ancho de banda del sistema una actualización de la memoria RAM del servidor?Actualizar la memoria RAM del servidor amplía los canales de datos activos en la placa base. Un módulo DDR5 de 64 GB de alto rendimiento transfiere datos a una velocidad de hasta 5600 MT/s. Esta alta velocidad reduce la latencia de la memoria durante operaciones paralelas intensas, eliminando así los cuellos de botella de rendimiento en todo el centro de datos.¿Qué hace que los módulos RDIMM sean la mejor opción de memoria RAM DDR5 para cargas de trabajo críticas?Los módulos RDIMM almacenan en búfer las señales de dirección y comando para reducir la carga eléctrica en los controladores de memoria. Seleccionar la mejor memoria RAM DDR5 garantiza una sólida integridad de la señal en configuraciones de múltiples canales DIMM. Este diseño de memoria para servidores equilibrado permite una actualización fluida del sistema sin sacrificar la frecuencia del bus.¿Qué ventajas ofrecen los módulos de doble rango a las actualizaciones de servidor planificadas?Los módulos 2Rx4 de doble rango equilibran la capacidad y la calidad de la señal en las pistas de la placa base. Maximizas la densidad por zócalo manteniendo un alto rendimiento de la memoria RAM DDR5 en todos los canales ocupados. Planificar actualizaciones estratégicas de servidores con hardware DDR5 protege tu infraestructura. Esta actualización de hardware optimiza el coste total de propiedad a largo plazo.
  • HBA vs. Controlador RAID: ¿Cuál es la mejor opción para el almacenamiento definido por software moderno?
    HBA vs. Controlador RAID: ¿Cuál es la mejor opción para el almacenamiento definido por software moderno?
    May 21, 2026
    Si la flexibilidad y la integración con soluciones RAID de software avanzadas son prioritarias para el almacenamiento definido por software moderno, debería elegir una tarjeta HBA. Una tarjeta RAID ofrece mayores velocidades de lectura y escritura secuenciales, menor latencia y un rendimiento superior de IOPS aleatorias, como se muestra a continuación:MétricoRendimiento del controlador RAIDRendimiento de la tarjeta HBAVelocidad de lectura secuencialHasta 12 Gb/sDepende del sistema anfitrión.Velocidad de escritura secuencialHasta 10 Gb/sDepende del sistema anfitrión.IOPS de lectura aleatoriaMás de 100.000Más de 50.000IOPS de escritura aleatoriaMás de 50.000Más de 20.000Estado latenteMenor latencia gracias al almacenamiento en caché.Mayor latenciaAntes de la implementación, es necesario evaluar el rendimiento, el costo y la compatibilidad. Este blog ofrece comparaciones claras y consejos prácticos. Conclusiones claveElija un adaptador HBA para obtener flexibilidad y acceso directo a la unidad en entornos de almacenamiento definidos por software.Los controladores RAID ofrecen un rendimiento superior y una excelente protección de datos, lo que los hace ideales para aplicaciones de misión crítica.Evalúe las necesidades de su carga de trabajo para seleccionar el controlador adecuado; HBA es apropiado para SDS modernos, mientras que RAID se ajusta a las configuraciones tradicionales.Compruebe siempre la compatibilidad y la compatibilidad del firmware antes de implementar soluciones HBA o RAID para garantizar un rendimiento óptimo.Al seleccionar soluciones de almacenamiento, tenga en cuenta el coste total de propiedad, incluidos el mantenimiento y el consumo de energía.HBA vs. Tarjeta RAID: Diferencias clave ¿Qué es un HBA?Se utiliza un adaptador de bus de host (HBA) para conectar el servidor a múltiples dispositivos de almacenamiento. Las tarjetas HBA actúan como controladores de paso directo, permitiendo que el sistema operativo acceda directamente a cada unidad conectada. Este acceso directo es esencial si se desean utilizar soluciones RAID por software, como ZFS o vSAN. En el almacenamiento empresarial, las tarjetas HBA ayudan a gestionar un gran número de unidades de forma eficiente. Es frecuente encontrar tarjetas HBA en centros de datos donde la flexibilidad y la compatibilidad con el almacenamiento definido por software avanzado son fundamentales. ¿Qué es una tarjeta RAID?Una tarjeta RAID, también llamada controlador RAID, administra múltiples unidades y las combina en una sola unidad virtual. La tarjeta RAID cuenta con su propio procesador y memoria caché. Realiza todos los cálculos RAID, como la segmentación, la duplicación y la paridad, sin utilizar la CPU principal del servidor. Esta descarga de procesamiento mejora el rendimiento y reduce la latencia. Las tarjetas RAID son esenciales cuando se necesita protección de datos basada en hardware y tiempos de reconstrucción más rápidos. En muchos entornos empresariales, las tarjetas RAID simplifican la administración del almacenamiento y admiten funciones avanzadas como el intercambio en caliente y el almacenamiento por niveles. Principales diferenciasAl comparar HBA con RAID, se observan varias diferencias arquitectónicas y operativas:Las tarjetas HBA funcionan como dispositivos de paso, lo que permite que el sistema operativo tenga control total sobre cada unidad. Esta configuración es ideal para RAID por software.Las tarjetas RAID gestionan internamente toda la lógica RAID. Presentan un único volumen lógico al sistema, que oculta las unidades subyacentes.En los centros de datos, a menudo se utiliza una unidad de arranque pequeña y se deja que una tarjeta HBA o una tarjeta RAID gestione el resto del almacenamiento.Ambos controladores admiten unidades de gran capacidad, pero es posible que necesite actualizar a controladores SAS o SATA de 6 Gb/s más recientes para unidades de más de 2,1 TB.Consejo: Si necesita almacenamiento por niveles o con intercambio en caliente, tanto las soluciones de controlador RAID como las de HBA pueden admitir estas funciones, dependiendo de su hardware.CaracterísticaDescripciónIntercambio en calienteTe permite reemplazar las unidades sin apagar el sistema.Almacenamiento por nivelesAdmite unidades SAS, SATA y NVMe para configuraciones de almacenamiento flexibles.Controlador únicoCombina múltiples protocolos, reduciendo la complejidad y el costo.Deberá elegir entre tarjetas RAID y tarjetas HBA en función de sus necesidades de RAID por hardware, RAID por software o funciones de almacenamiento avanzadas.Ventajas y desventajas Ventajas y desventajas de HBAAl evaluar las tarjetas HBA para almacenamiento definido por software, se encuentran varias ventajas claras:Se beneficia de una buena relación costo-beneficio, especialmente al usar adaptadores HBA iSCSI sobre redes Ethernet estándar. Este enfoque evita la necesidad de hardware especializado y costoso.Obtendrás velocidades de transferencia de datos más rápidas. Las tarjetas HBA crean una vía directa y eficiente para el flujo de información, lo cual es esencial para grandes conjuntos de datos y aplicaciones de alto rendimiento.Disfrutará de mayor fiabilidad y estabilidad. Funciones como el enrutamiento múltiple y la conmutación por error mantienen su almacenamiento conectado y reducen el riesgo de corrupción de datos o fallos del sistema. La corrección de errores avanzada y la arquitectura robusta le permiten gestionar cargas de trabajo intensas con un rendimiento constante. Sin embargo, también debe tener en cuenta las limitaciones de las tarjetas HBA en implementaciones a gran escala:LimitaciónDescripciónAncho de banda limitadoLas interconexiones más antiguas (de 6 a 12 Gbps) fallan bajo cargas de trabajo intensas.Rendimiento de E/S limitadoLimitado por la ineficiencia del protocolo y el firmware obsoleto.Desafíos de escalabilidadEs difícil ampliar las matrices de almacenamiento sin interrupciones o reconfiguración.Riesgos de compatibilidadEs posible que las tarjetas controladoras más antiguas no sean compatibles con protocolos de almacenamiento modernos como NVMe o Fibre Channel Gen7.Mayores tasas de fracasoLa falta de certificación del proveedor conlleva una asistencia al conductor inconsistente y un mayor tiempo de inactividad.Siempre debe comprobar la compatibilidad y el soporte del firmware antes de implementar tarjetas HBA en entornos de misión crítica. Ventajas y desventajas de las tarjetas RAIDLas tarjetas RAID ofrecen varias ventajas clave para la protección de datos y el rendimiento en los sistemas de almacenamiento tradicionales:La redundancia de datos se logra mediante la duplicación y la paridad, lo que mantiene los datos disponibles incluso si falla una unidad.Se minimiza el tiempo de inactividad porque el mejor controlador RAID puede reconstruir automáticamente los datos después de un fallo en la unidad.Disfrutará de una mayor fiabilidad, ya que la caída de un solo nodo no afecta a todo el sistema. Esta configuración mantiene la coherencia de los datos y previene su pérdida.Se observa un mayor rendimiento de los discos duros y las unidades SSD. Las tarjetas RAID mejoran el rendimiento al permitir operaciones simultáneas de lectura y escritura en múltiples unidades.Usted se beneficia de la protección de datos integrada a través de varios niveles RAID, como RAID 1, RAID 5 y RAID 6.Los controladores RAID gestionan las unidades mediante operaciones complejas como la segmentación de datos, que divide los datos en fragmentos y los escribe en varias unidades simultáneamente. Este proceso mejora el rendimiento, especialmente al usar un controlador RAID para almacenamiento SSD. A pesar de estas ventajas, el uso de tarjetas RAID en entornos de almacenamiento definidos por software presenta varios desafíos:Puede producirse una sobrecarga de rendimiento debido a que el RAID por software depende de la CPU para la gestión, lo que puede ralentizar el sistema.Es posible que encuentre niveles RAID limitados, lo que restringe su flexibilidad.Pueden surgir problemas de escalabilidad, ya que modificar una configuración RAID por software es complejo y arriesgado.La dependencia del sistema operativo significa que la integridad de su matriz RAID está directamente ligada al sistema operativo, lo que puede causar problemas si este falla.Las limitaciones de rendimiento bajo carga aparecen en entornos con un alto volumen de E/S, donde el RAID por software puede no ser compatible con las soluciones de hardware.Cuando se utiliza un controlador RAID en modo JBOD, ZFS puede crear vdevs con múltiples dispositivos, pero el controlador sigue gestionando el almacenamiento de forma independiente. Esta configuración puede provocar problemas de rendimiento y de integridad de los datos debido a posibles conflictos entre las operaciones de ZFS y la gestión del controlador. Tabla comparativa: HBA frente a RAIDPuede utilizar la siguiente tabla para comparar las soluciones de tarjetas HBA y RAID para su entorno de almacenamiento:Característica/AspectoTarjetas HBATarjetas RAIDCostoMenor, especialmente con iSCSI y Ethernet estándar.Superior, requiere hardware especializadoActuaciónAlto rendimiento con acceso directo, pero limitado por las interconexiones y el firmware.Superior para E/S secuenciales y aleatorias, especialmente con caché y SSD.Protección de datosSe basa en RAID por software (por ejemplo, ZFS, vSAN).Redundancia integrada (duplicación, paridad, reserva en caliente)EscalabilidadResulta complicado en matrices grandes.Más fácil con controladores avanzadosCompatibilidadPuede que falte soporte para los protocolos más recientes.Soporte amplio, pero puede limitar las funciones avanzadas de SDS.Utilización de la cachéNo hay caché a bordoLa memoria caché integrada mejora el rendimiento y reduce la latencia.Modo JBODSoporte nativoCompatible, pero puede entrar en conflicto con SDS como ZFS.Eficiencia del RAID por softwareAlto, especialmente con las CPU modernas y ZFS.Puede estar limitado por la abstracción del controlador.Optimización de SSDDepende del modelo HBAEl mejor controlador RAID para SSD maximiza el rendimiento de la SSD.FiabilidadCorrección de errores avanzada, pero mayor riesgo de fallos si no está certificada.El mejor controlador RAID ofrece una protección robusta y reconstrucciones automáticas.Debe elegir entre tarjetas HBA y RAID según sus necesidades de rendimiento, protección de datos y compatibilidad con su plataforma de almacenamiento definida por software. El mejor controlador RAID suele ofrecer un rendimiento y una fiabilidad superiores para matrices SSD y HDD, pero las tarjetas HBA brindan flexibilidad y ahorro de costes para las soluciones SDS modernas. Rendimiento en el almacenamiento definido por software SDS con HBASe obtiene la máxima flexibilidad al usar un HBA en un entorno de almacenamiento definido por software. El HBA actúa como un dispositivo de paso directo, lo que permite que el sistema operativo o el software de almacenamiento administren cada unidad directamente. Esta configuración funciona bien con plataformas como vSAN y ZFS, donde el software gestiona la redundancia y la protección de datos. Puede escalar su almacenamiento fácilmente y adaptarse a las demandas cambiantes de la carga de trabajo. La ausencia de lógica RAID por hardware significa que se evita la sobrecarga adicional, lo que puede mejorar el rendimiento bajo cargas de trabajo reales, especialmente al usar matrices SSD de gama alta. Sin embargo, debe asegurarse de que sus recursos de CPU y memoria sean suficientes, ya que los cálculos RAID por software utilizarán recursos del host.CaracterísticaJBOD (HBA)Controlador RAIDGestión de datosGestionado por software/sistema operativoGestionado por lógica RAID de hardwareRedundanciaGestionado por software (por ejemplo, vSAN, ZFS)Funciones de redundancia integradasActuaciónFlexible, sin sobrecarga RAIDPuede ofrecer baja latencia con caché de hardware.Caso de usoIdeal para soluciones de almacenamiento definidas por software.Adecuado para entornos que requieren lógica RAID. Tarjeta RAID en SDSLos controladores RAID de hardware ofrecen ventajas cuando se requiere alto rendimiento y fiabilidad. Estos controladores funcionan como miniordenadores, ejecutando firmware especializado para gestionar algoritmos RAID y almacenar en búfer las operaciones de entrada/salida con caché integrada. Esta arquitectura reduce las interrupciones de la CPU y los cambios de contexto, lo que aumenta las IOPS y disminuye la latencia. Se obtienen los mejores resultados en entornos con cargas de trabajo intensivas de lectura/escritura aleatoria, como bases de datos o aplicaciones de IA. La caché integrada, especialmente con respaldo de batería, mejora la velocidad de escritura y reduce el tiempo de espera de las aplicaciones. Los controladores RAID admiten múltiples niveles RAID y funciones avanzadas como la gestión de discos de reserva en caliente, lo que mejora la fiabilidad y el rendimiento tanto para matrices de HDD como de SSD. Los controladores RAID de hardware actúan como minicomputadoras integradas en los servidores, ejecutando firmware especializado, administrando algoritmos RAID y almacenando en búfer las operaciones de entrada/salida con caché integrada, lo que reduce las interrupciones de la CPU y los cambios de contexto a nivel del sistema operativo.Esta arquitectura mejora las IOPS y reduce la latencia para cargas de trabajo de lectura y escritura aleatorias, lo que la hace ideal para aplicaciones críticas para el negocio.Los controladores RAID de hardware empresariales admiten múltiples niveles RAID (por ejemplo, 0, 1, 5, 6, 10) y funciones avanzadas como la gestión de discos de reserva en caliente y el análisis predictivo de unidades, lo que mejora la fiabilidad y el rendimiento.El RAID por software es rentable y flexible, lo que lo hace adecuado para entornos de desarrollo, servidores de archivos a pequeña escala y laboratorios domésticos donde abundan los ciclos de CPU.Sin embargo, el RAID por software puede tener problemas de rendimiento en escenarios de alta demanda y es más adecuado para implementaciones no críticas, a menos que se combine con SSD de gama alta y suficiente capacidad de CPU. Cargas de trabajo de vSAN, ZFS e IASe aprecian diferencias claras al implementar cargas de trabajo de vSAN, ZFS o IA. Tanto vSAN como ZFS prefieren el acceso directo a la unidad, que se logra con una HBA. Este enfoque ofrece flexibilidad y permite utilizar funciones de software avanzadas para la protección y recuperación de datos. Para cargas de trabajo de IA, a menudo se requiere la menor latencia posible y el mayor número de IOPS. Los controladores RAID con caché dedicada y lógica RAID ofrecen un rendimiento superior en estos casos, especialmente con almacenamiento SSD. Debe elegir el controlador que mejor se adapte a las necesidades de su carga de trabajo. Si prioriza la flexibilidad y las funciones de almacenamiento definido por software, elija una HBA. Si necesita el máximo rendimiento y fiabilidad para cargas de trabajo de IA o bases de datos críticas, un controlador RAID con soporte para SSD es la mejor opción. Protección de datos y redundanciaRAID y protección de datosUsted confía en RAID para una protección de datos robusta en el almacenamiento empresarial. Los niveles RAID 5, 6 y 10 ofrecen diferentes equilibrios entre rendimiento, redundancia y capacidad. RAID 5 ofrece una excelente combinación de velocidad y tolerancia a fallos, lo que lo convierte en una opción común para servidores. RAID 6 aumenta la protección de datos al agregar doble paridad, lo que significa que puede perder dos discos sin perder datos. RAID 10 combina duplicación y distribución de datos, por lo que obtiene alto rendimiento y redundancia, pero necesita más discos y enfrenta mayores costos. Cuando utiliza configuraciones RAID con redundancia, reduce significativamente el riesgo de pérdida de datos. Sin embargo, RAID no protege contra borrados accidentales ni ciberataques. Siempre debe mantener copias de seguridad externas para garantizar una protección de datos completa. RAID 5: Equilibra rendimiento, redundancia y capacidad.RAID 6: Ofrece una mayor tolerancia a fallos gracias a su doble paridad.RAID 10: Ofrece alto rendimiento y redundancia, pero a un coste más elevado.Los niveles RAID redundantes reducen el riesgo de pérdida de datos.RAID no puede evitar la pérdida de datos por borrado accidental o amenazas cibernéticas. RAID por software con HBAPuedes lograr una protección de datos flexible combinando RAID por software con una HBA. La HBA actúa como un adaptador, permitiendo que tu software administre cada unidad directamente. Esta configuración funciona bien con plataformas como ZFS o Ceph, donde se requieren funciones avanzadas de integridad de datos. Las tarjetas HBA modernas con soporte para SAS-4, capacidades trimodo e integración PCIe 5.0 mejoran el rendimiento y la confiabilidad. Obtendrás hasta un 50 % más de IOPS y un menor consumo de energía, lo que respalda las iniciativas de centros de datos ecológicos. El firmware en modo IT de las tarjetas HBA reduce los cuellos de botella, lo que se traduce en un mejor rendimiento para el almacenamiento definido por software. Las tarjetas HBA Fibre Channel ofrecen una latencia ultrabaja, fundamental para clústeres de alta disponibilidad. Debes elegir el controlador RAID o HBA más adecuado según tu carga de trabajo y tus necesidades de protección de datos. Fiabilidad en SDSAl implementar almacenamiento definido por software, es fundamental priorizar la fiabilidad. Las tarjetas HBA SAS predominan en la mayoría de las implementaciones gracias a su rendimiento constante y su sólida integridad de datos. Las HBA de triple modo admiten NVMe over Fabrics, lo que aumenta las IOPS y mejora la fiabilidad. Se recomienda usar firmware en modo IT para evitar cuellos de botella en el controlador RAID y maximizar la integridad de los datos. Los nuevos modelos de HBA consumen menos energía, lo que ayuda a cumplir con los objetivos operativos y medioambientales. El mejor controlador RAID ofrece reconstrucciones automáticas y corrección de errores avanzada, lo que garantiza la seguridad de los datos. Las tarjetas RAID con caché con respaldo de batería protegen los datos durante cortes de energía, añadiendo una capa adicional de protección. Para lograr la máxima fiabilidad y rendimiento, siempre se debe adaptar el hardware a la plataforma de almacenamiento definido por software.Consejo: Combine siempre RAID con copias de seguridad periódicas para garantizar la protección e integridad total de los datos, incluso ante fallos inesperados.Consideraciones de despliegue Compatibilidad del servidorAntes de implementar cualquier solución de almacenamiento, es necesario verificar la compatibilidad del servidor. Marcas importantes como Dell, HPE, Lenovo y Supermicro ofrecen servidores compatibles con controladores HBA y RAID. Debe verificar la versión del firmware y el tipo de interfaz. Muchos servidores empresariales son compatibles con unidades SAS, SATA y NVMe. Si planea usar SSD o NVMe, seleccione un controlador RAID para SSD o NVMe que sea compatible con su hardware. Asegúrese de que su controlador sea compatible con los protocolos más recientes y ofrezca un rendimiento óptimo. Algunos servidores requieren controladores propietarios, por lo que debe consultar la documentación del proveedor. La compatibilidad influye en el rendimiento, la integridad de los datos y la confiabilidad. Cuándo evitar las tarjetas RAIDDebe evitar el uso de tarjetas RAID en ciertos entornos de almacenamiento definidos por software. Si implementa ZFS, vSAN o Ceph, necesita acceso directo a cada unidad. Un controlador RAID puede interferir con la lógica RAID por software y reducir el rendimiento. Puede experimentar conflictos entre la administración de hardware y software, lo que puede comprometer la integridad de los datos. Cuando utiliza matrices SSD para cargas de trabajo de alto rendimiento, el RAID por software con una HBA suele ofrecer mayor flexibilidad. También debe evitar las tarjetas RAID si desea funciones avanzadas como instantáneas o aprovisionamiento ligero. En implementaciones nativas de la nube, el RAID por software proporciona una escalabilidad e integración más sencillas.Consejo: Compruebe siempre si su plataforma SDS recomienda el modo JBOD o el acceso directo a la unidad. Esto garantiza el máximo rendimiento y la integridad de los datos. Escenarios prácticosPuedes optimizar tu implementación de almacenamiento seleccionando el controlador adecuado para tu carga de trabajo. Para servidores de bases de datos que requieren un alto rendimiento de IOPS aleatorias, un controlador RAID con caché mejora el rendimiento. Si ejecutas cargas de trabajo de IA, elige un controlador compatible con SSD y NVMe para una baja latencia. En servidores de respaldo o almacenamiento de archivos, el RAID por software con una HBA ofrece ahorro de costos y flexibilidad. Debes usar RAID por hardware para aplicaciones de misión crítica donde el tiempo de inactividad es inaceptable. Para laboratorios domésticos o entornos de desarrollo, el RAID por software te brinda mayor control y una expansión más sencilla. Siempre busca un equilibrio entre rendimiento, confiabilidad e integridad de los datos al elegir entre controladores HBA y RAID.GuiónSolución recomendadaRazónServidor de base de datosControlador RAIDAlto rendimiento, redundanciaCarga de trabajo de IAControlador RAID para NVMe/SSDBaja latencia, máximo IOPSCopia de seguridad/Almacenamiento de archivosHBA + RAID por softwareRentable y flexibleEntorno de laboratorio doméstico/desarrolloHBA + RAID por softwareFácil expansión y controlSDS nativo de la nubeHBA + RAID por softwareEscalabilidad, integraciónAsesoramiento en materia de costes y adquisiciones Costo total de propiedadAl evaluar soluciones de almacenamiento, es necesario considerar más allá del precio inicial del hardware. El costo total de propiedad incluye el medio de almacenamiento, el diseño del controlador, las licencias, el mantenimiento, el consumo de energía, la refrigeración y la expansión futura. Los adaptadores HBA y RAID de Smart Storage ofrecen firmware y software unificados, lo que simplifica la administración y reduce los costos operativos. Se observa un aumento del rendimiento y un ahorro de energía de hasta un 40 %. La implementación y administración de los adaptadores HBA optimizan los procesos y aumentan la utilización de recursos. Este enfoque reduce el costo total de propiedad, especialmente en entornos donde la flexibilidad es fundamental.El firmware unificado reduce la complejidad.El ahorro energético reduce los gastos operativos.Una gestión simplificada reduce los costes de mantenimiento.La utilización eficiente de los recursos mejora el retorno de la inversión. Escalabilidad en SDSAl implementar almacenamiento definido por software (SDS), es fundamental considerar la escalabilidad. Las HBA facilitan la expansión y la integración con plataformas como ZFS y Ceph, permitiendo agregar unidades o nodos sin necesidad de una reconfiguración importante. Esta flexibilidad permite un rápido crecimiento en entornos empresariales y en la nube. Los controladores RAID ofrecen un rendimiento robusto para cargas de trabajo tradicionales, pero pueden presentar limitaciones debido a la dependencia del proveedor y fallos de caché. Para implementaciones modernas de SDS, se evitan estos riesgos al elegir HBA. El mejor controlador RAID admite grandes matrices y funciones avanzadas, pero es necesario sopesar la escalabilidad frente a los costos a largo plazo. Recomendaciones de expertosDebe elegir el controlador adecuado según su carga de trabajo y objetivos de implementación. Los expertos recomiendan las HBA para entornos de almacenamiento definidos por software, como ZFS y Ceph. Los controladores RAID son ideales para cargas de trabajo empresariales tradicionales y aplicaciones de misión crítica. En los centros de datos modernos, se evitan las tarjetas RAID para prevenir la dependencia de un proveedor y los fallos de caché. El mejor controlador RAID ofrece alto rendimiento y fiabilidad para servidores VMware y de bases de datos. La integración con cargas de trabajo de IA se logra mediante el uso de HBA, especialmente en clústeres vSAN y ZFS. Este enfoque permite un ahorro del 20-30 % en el coste total de propiedad gracias a la flexibilidad de JBOD.Tipo de controladorCacheBBU/SupercapMejor caso de usoNivel de riesgoRAID de hardware básicoPequeñoOpcionalLaboratorios, copias de seguridadMedioEmpresa de gama mediaMedioSíServidores, RAID 10BajoEmpresa de alta gamaGrandeSíVMware, bases de datosMuy bajoHBANingunoN / AZFS, CephDependeConsejo: Evalúe siempre sus planes de crecimiento futuros y los requisitos de carga de trabajo antes de seleccionar el mejor controlador RAID o HBA para su entorno.  Para obtener el máximo provecho del almacenamiento definido por software, elija un adaptador HBA que le brinde flexibilidad y administración directa de las unidades. La protección de datos sigue siendo fundamental en cualquier implementación. Para obtener los mejores resultados, siga estos pasos:Verifique la compatibilidad de las ranuras para evitar problemas de ancho de banda.Elija la cantidad adecuada de puertos para garantizar la protección y la redundancia de los datos.Confirme la compatibilidad del controlador y del sistema operativo para una protección de datos estable.Decide si necesitas acceso directo o gestión de disco para una protección de datos óptima.Las plataformas SDS gestionan la protección de datos en la capa de software.HBA o RAID en modo IT admite la protección transparente de datos.El RAID por hardware puede limitar la protección de datos en SDS.Evalúe sus necesidades para garantizar el equilibrio adecuado entre rendimiento y protección de datos.Preguntas frecuentes¿Cuál es la principal ventaja de utilizar un HBA en el almacenamiento definido por software?Con una HBA, obtienes acceso directo a la unidad. Esta configuración permite que tu software gestione la redundancia y la protección de datos. Lograrás mayor flexibilidad y una integración más sencilla con plataformas como ZFS y vSAN.¿Se pueden combinar controladores HBA y RAID en un mismo servidor?Puedes combinarlos, pero debes planificarlo cuidadosamente. La combinación de controladores puede causar problemas de compatibilidad o complicar la gestión. Consulta siempre las recomendaciones de tu plataforma SDS antes de combinarlos.¿El RAID por software con HBA afecta al rendimiento de la CPU?Sí, el RAID por software utiliza la CPU del servidor para los cálculos de RAID. Debe asegurarse de que su sistema tenga suficiente potencia de procesamiento para gestionar tanto las tareas de almacenamiento como las cargas de trabajo de las aplicaciones.¿Qué controlador debería elegir para las unidades NVMe?Debe seleccionar una controladora HBA o RAID compatible con NVMe. Muchas controladoras HBA modernas ofrecen compatibilidad con tres modos: SAS, SATA y NVMe, lo que le brinda la máxima flexibilidad para el almacenamiento de alta velocidad.

dejar un mensaje

dejar un mensaje
Si está interesado en nuestros productos y desea obtener más detalles, por favor Deja un mensaje aquí, te responderemos lo antes posible.

Hogar

Productos

Contáctanos

dejar un mensaje
Si está interesado en nuestros productos y desea obtener más detalles, por favor Deja un mensaje aquí, te responderemos lo antes posible.